Episoden / episode 12 / 52:03
Jev AI in der Praxis und Local SEO/GEO 2026
Jens zeigt sein selbstgebautes Belege-Tool mit Jev, das 224 Entscheidungen für einen Cent trifft, und Christoph erklärt, wie Local SEO und GEO 2026 funktionieren, vom Unternehmensprofil bis zu den Quellen der AI-Antworten. Dazu Snacks zu AGENTS.md in Claude Code, Opus 5.5, DHH, Better Auth, KI-Videos mit Claude Code und Agentic Browsing in PageSpeed Insights.
mit Jens Becker & Christoph Paterok
Begrüßung: Snacks und zwei große Themen
Aufgenommen am 30. September, wie immer etwa eine Woche vor der Veröffentlichung. Bei Folge 11 hat Christoph das zum ersten Mal gemerkt: Beim Aufnehmen fühlten sie sich mit Jev früh dran, zur Veröffentlichung war das Thema schon auf dem Peak. Das Format bleibt wie beim letzten Mal: Jeder bringt ein paar Snacks mit und ein großes Thema. Versprochen: keine Business-Themen, keine Sales-Bücher.
Jens greift Jev noch einmal ausführlich auf und zeigt eine Personalized Software, die er für seinen Geschäftsalltag gebaut hat. Christoph bringt einen Klassiker mit: Local SEO und GEO 2026. Für ihn ist „Kannst du mich bei Google oder ChatGPT sichtbar machen?“ inzwischen das neue „Kannst du mir den Druckertreiber einrichten?“. Und beide geben zu: Jeden Tag kommt etwas Neues dazu, das sie sich anschauen wollen und nicht schaffen. Genau dafür ist der Podcast auch da.
Christophs Snacks: Google ruft an, KI-Videos und Better Auth
Snack eins: Google ruft für dich beim Handwerker an. In den USA kann man mit eingeloggtem Google-Account nach etwa „plumber near me“ suchen und bekommt einen Button, mit dem die KI die Preise abfragt. Google stellt ein paar Fragen, fragt dann selbst bei den Betrieben an, und die Antworten kommen per E-Mail. Christoph hat keinen US-Account und zeigt deshalb Screenshots aus einem Artikel bei Search Engine Journal. Für ihn zeigt das, wohin die Reise geht: Agentic Browsing.
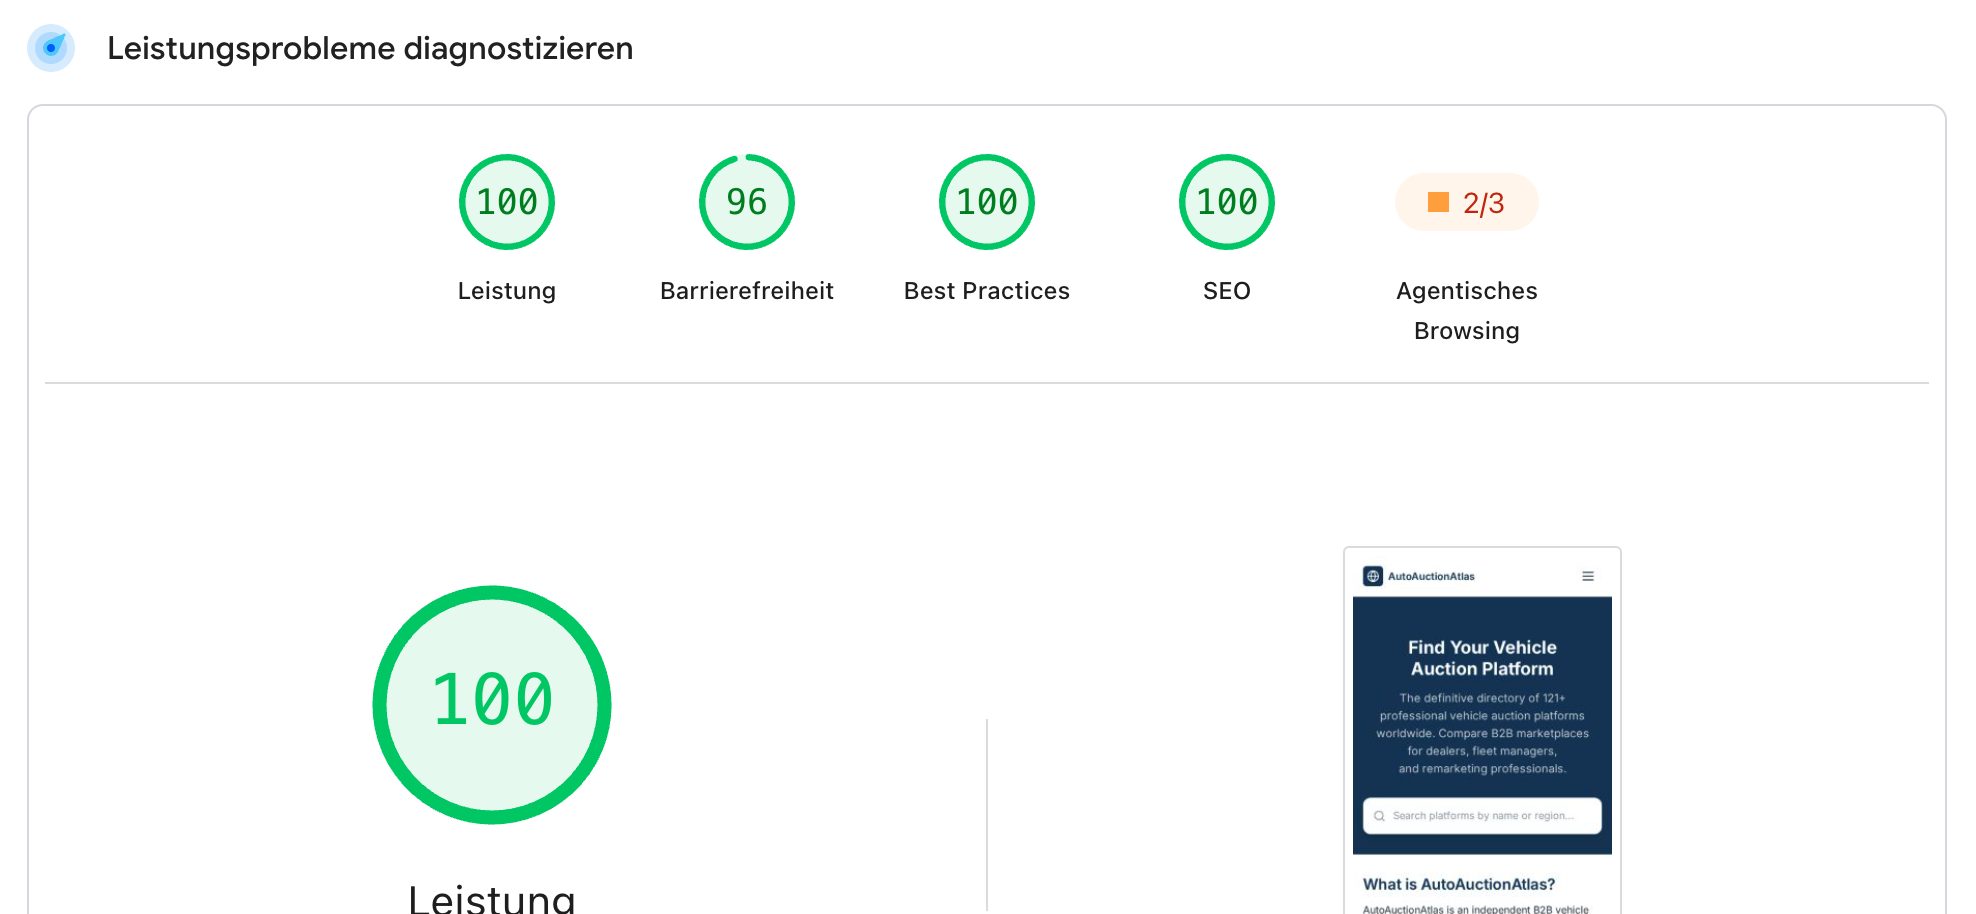
Das gibt es inzwischen auch in PageSpeed Insights, in Lighthouse schon etwas länger. Neben Leistung, Barrierefreiheit, Best Practices und SEO steht jetzt „Agentisches Browsing“. Christoph hat dabei direkt festgestellt, dass seine llms.txt nicht richtig formatiert ist. Google sagt zwar, dass es llms.txt nicht nutzt, prüft hier aber, ob der Standard eingehalten wird. Das größere Thema dahinter ist WebMCP, mit dem man die eigene Website für Agents nutzbar macht. Google hat dazu eine ausführliche Dokumentation.
Snack zwei: Claude Code baut Videos. Neu ist das nicht, aber die Qualität hat Christoph überrascht, und er weiß nicht genau, ob es an Opus 5.5 liegt oder an der Art, wie die Videos entstehen. Ausgelöst hat das ein Reddit-Post mit einem Video über den Sinn des Lebens, gebaut mit einem einzigen Prompt. Christoph hat es nachgebaut: ein neuer Ordner, ein OpenRouter-API-Key in der .env, sonst nichts. Dazu der Prompt aus dem Post, ein Budget und sein Artikel darüber, wie man Texte schreibt, die eine KI zitiert. Außerdem hat er Claude Code auf das Repository seiner Website verwiesen, um die CSS-Tokens zu übernehmen. Über OpenRouter generiert Claude Code die Assets und setzt sie zusammen.
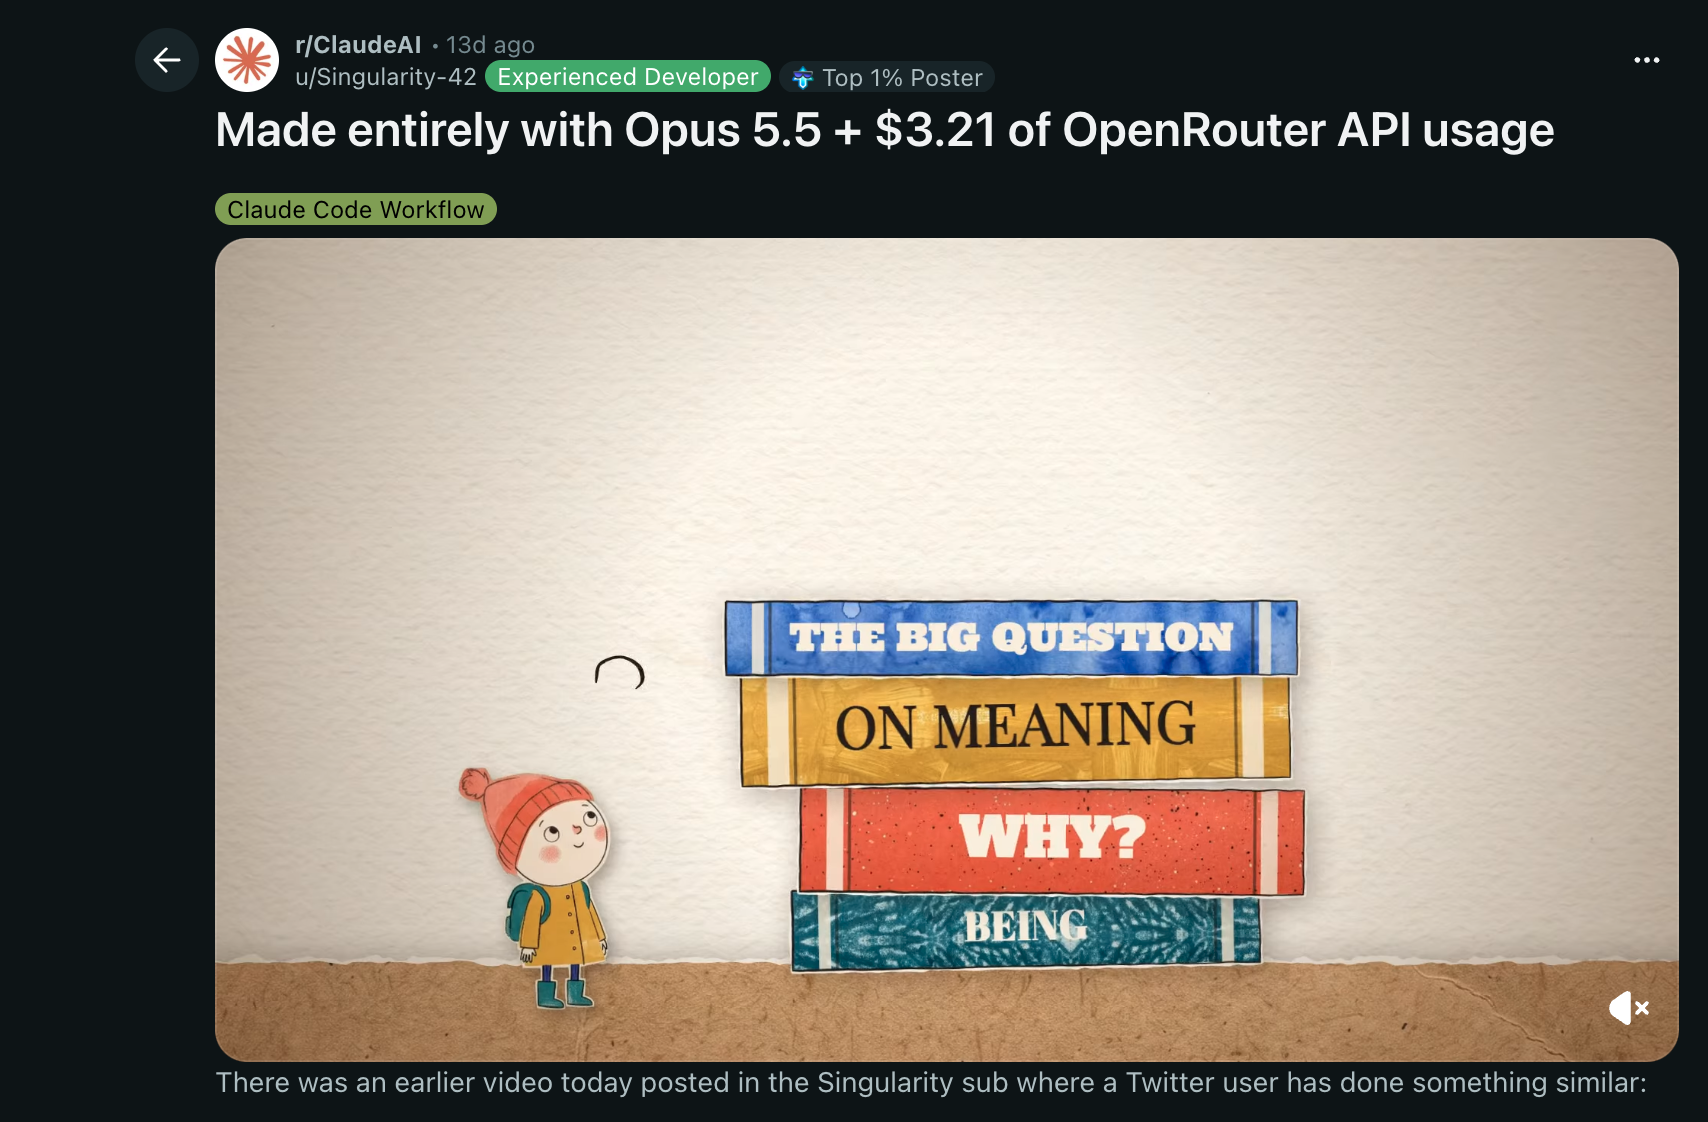
Christoph ist nach eigener Aussage kein Instagram-Guy, hat aber einen neuen Account angelegt und das Video als Reel gepostet: knapp 3.000 Views, fast 30-mal gespeichert. Dass der Stil in zwei, drei Wochen ausgelutscht ist, glaubt er nicht, weil die Hürde doch etwas höher ist. Inhaltlich kommt trotzdem etwas rüber, deshalb seine Empfehlung: ausprobieren. Jens hat die Videos auch gesehen und ist vor allem von den vielen Animationen und Übergängen beeindruckt.
Snack drei ist ein technischer: Christoph baut gerade eine Software as a Service und hat bisher oft Supabase genommen, eigentlich nur für den Login. Jetzt hat er Better Auth entdeckt, eingebaut, und es lief so einfach, dass er es zeigen wollte. Supabase hat in den letzten ein, zwei Jahren einen Hype erlebt, weil es sich schnell in die Vibe-Coding-Tools integriert hat. Christophs Hinweis: Wer Software baut, sollte sich Better Auth anschauen, bevor er zu Supabase greift, und dabei auch Abhängigkeiten lösen. Jens nutzt Better Auth in zwei Projekten mit einer Postgres-Datenbank und kann es ebenfalls empfehlen.
Jens' Snacks: AGENTS.md, Opus 5.5 und DHH
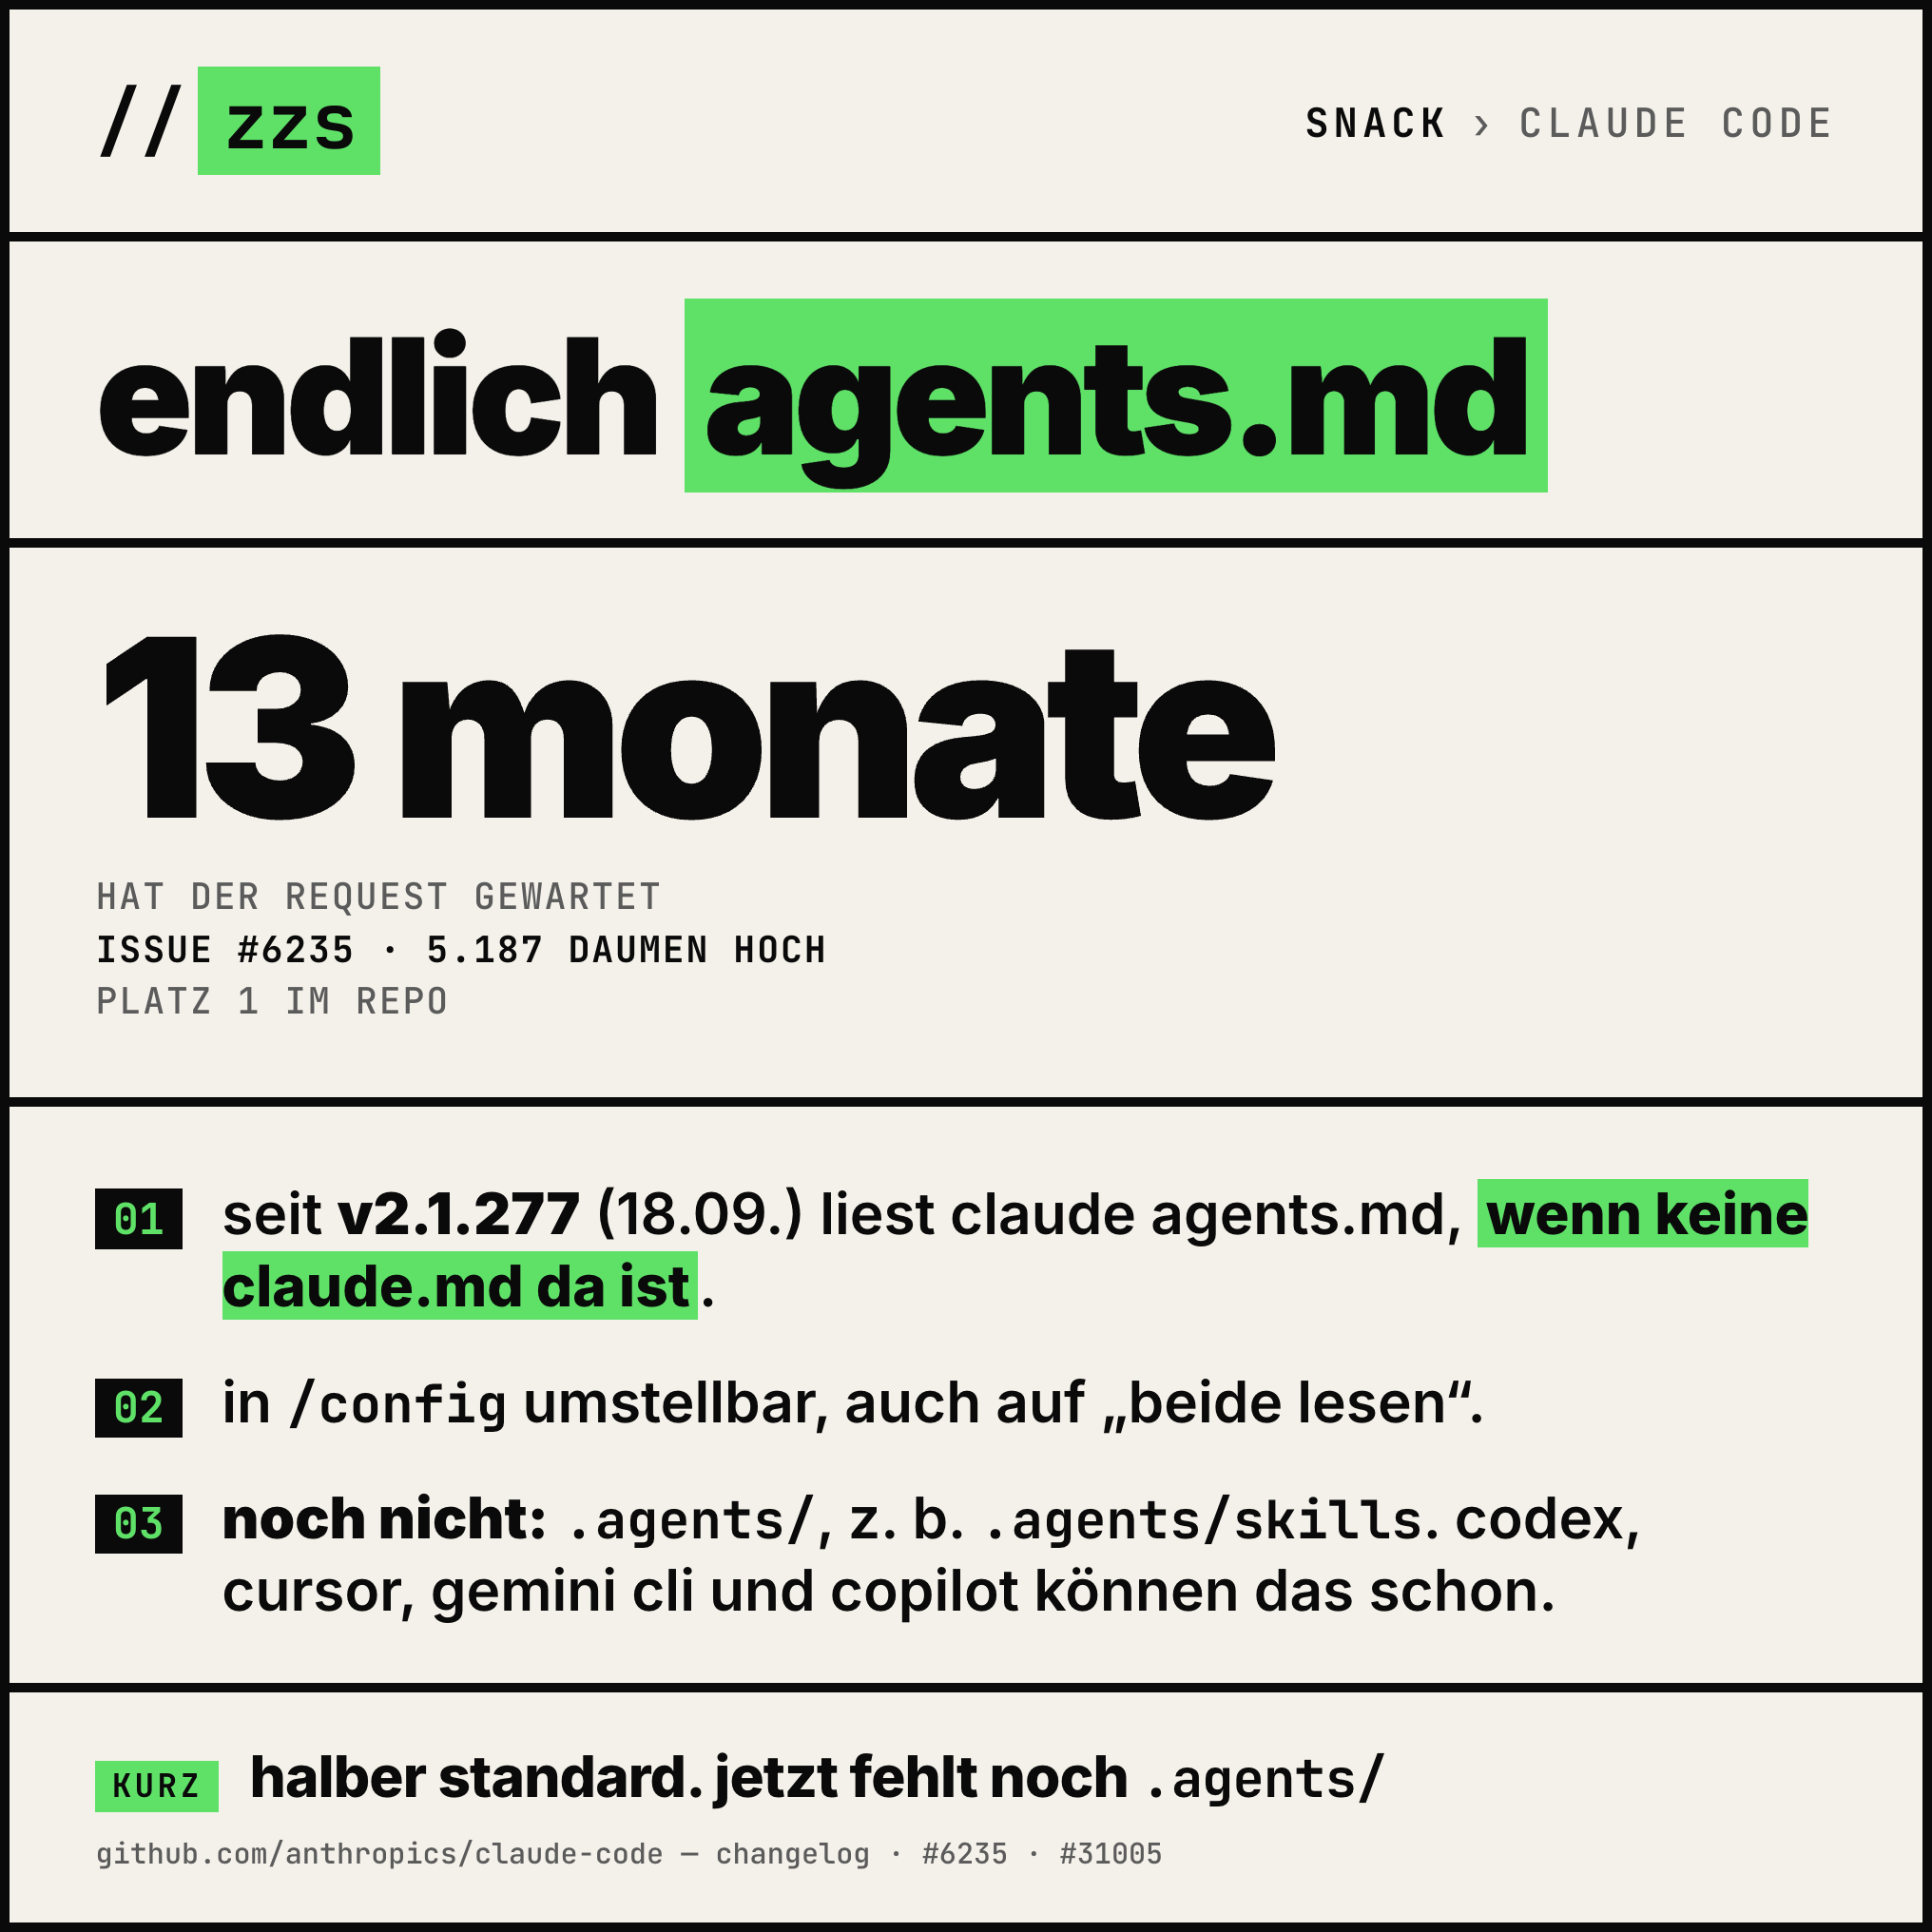
Snack eins: Nach 13 Monaten unterstützt Claude Code endlich AGENTS.md. Der Standard sieht Markdown-Dateien vor, in denen man Instructions für Agents in die Codebase legt. Claude Code war einer der wenigen Harnesses, die nur ihre eigene CLAUDE.md gelesen haben. Das Issue dazu stand mit über 5.000 Daumen auf Platz eins im Repo. Eigentlich eine Kleinigkeit, aber für Jens war es nervig: Jedes Mal, wenn er einen anderen Harness wie Codex ausprobieren wollte, stellte sich die Frage, was mit der Datei passiert. Ein Symlink oder eine Referenz geht, ist aber unnötiger Mehraufwand. Was noch fehlt, ist der Rest des Standards: der Ordner .agents, in dem zum Beispiel die Skills liegen. Jens hofft, dass das nicht wieder 13 Monate dauert. Details stehen in der Claude-Code-Doku.
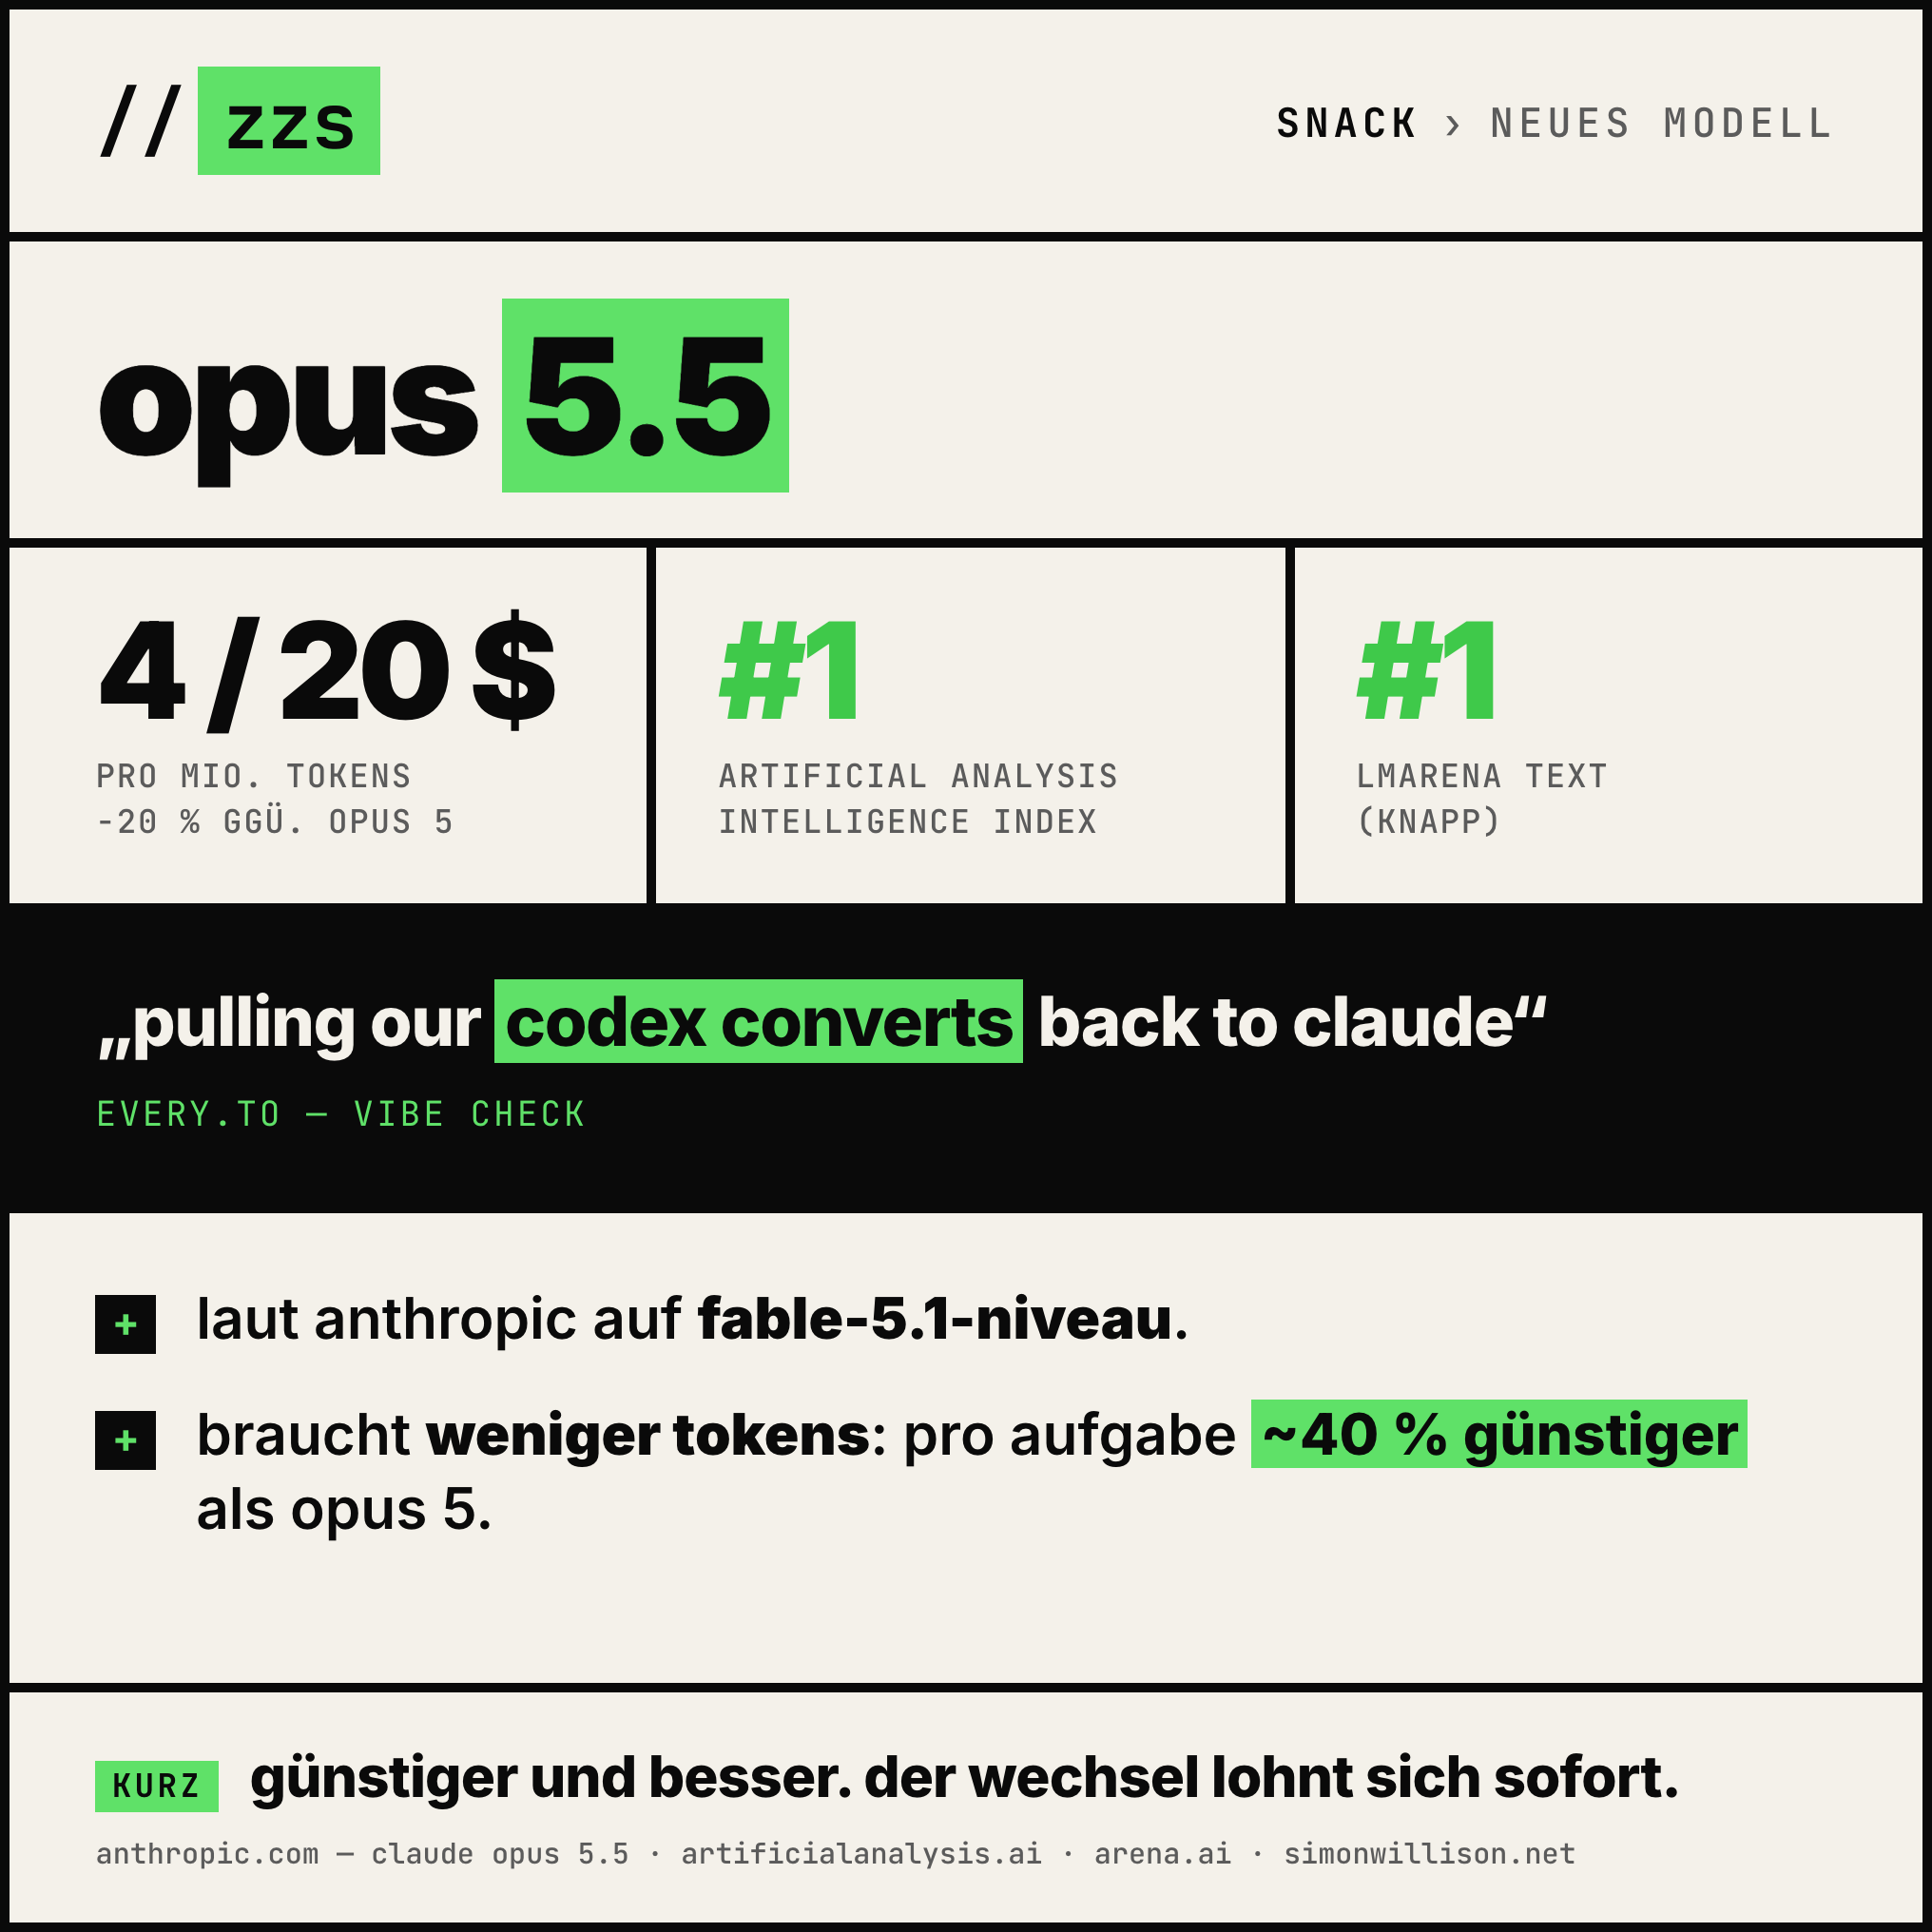
Snack zwei: Opus 5.5. Jens ist sehr zufrieden, mit dem Pricing und damit, dass es macht, was es soll. Bisher hat er Fable für die Orchestrierung genutzt und Opus als Subagent für die Implementierung. Jetzt macht er alles mit Opus und testet das gerade. Every titelt dazu: „Opus 5.5 is pulling our Codex converts back to Claude“. Für Jens zählen der Harness, die Codebase und die Optimierungen drumherum aber mehr als die Frage, ob gerade OpenAI oder Anthropic das bessere Modell hat.
Christoph geht es genauso: Er hat ebenfalls Fable mit Opus-Agents genutzt und Fable inzwischen fast ausgeschaltet. Opus 5.5 fühlt sich für ihn weniger komplex an, Fable hat vieles kompliziert gemacht. Jens ergänzt: Die riesige Wall of Text ist mit Opus 5.5 subjektiv besser geworden. Christoph hat außerdem seit ein paar Wochen wieder ChatGPT Pro. Er gibt Screenshots seiner Websites rein, lässt ChatGPT den Art Director spielen und sich den Prompt für Claude Code schreiben. Die beiden zusammen machen einen guten Job. Eine ähnliche Kombination nutzt Arne, ein Bekannter von Jens: Codex, das Opus-Subagents spawnt. Beide merken, dass man viel zu selten mit Kollegen darüber spricht, wie sie Claude Code eigentlich benutzen.
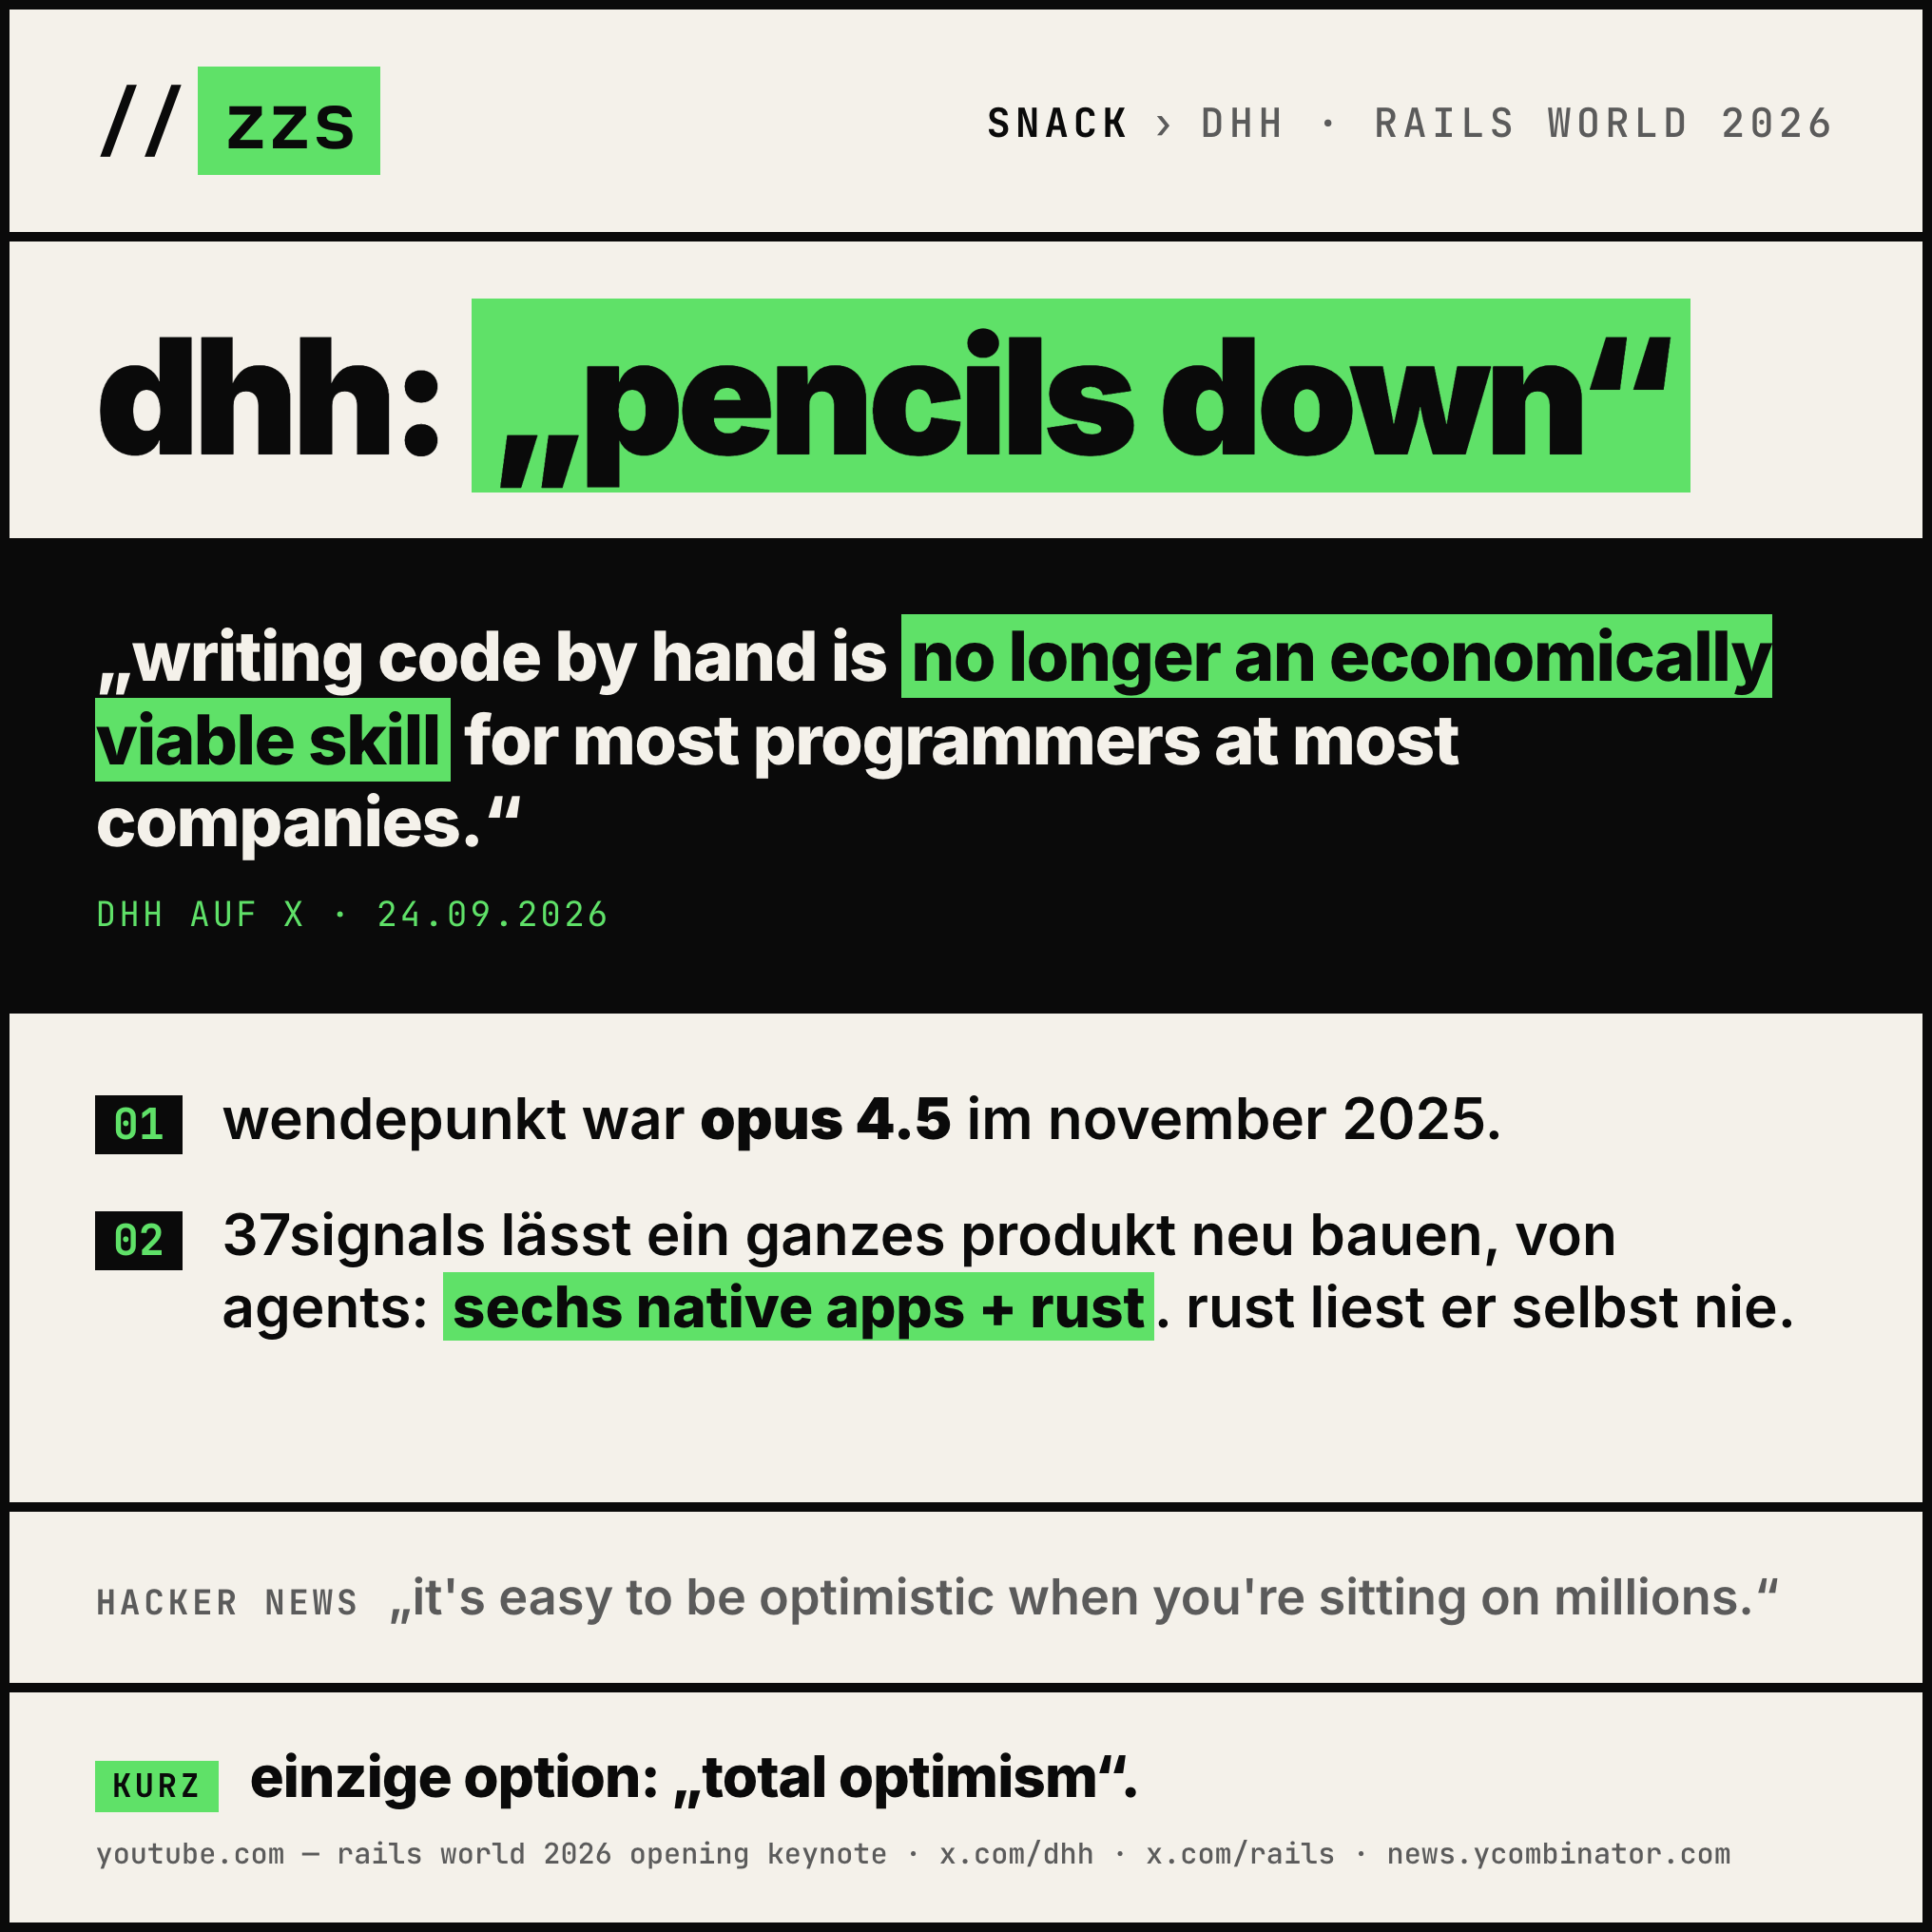
Snack drei: DHH, der Erfinder von Ruby on Rails, hat auf der Rails World 2026 weniger über Rails und mehr über KI gesprochen. Jens greift nur einen Satz heraus, den DHH auch auf X gepostet hat: „Writing code by hand is no longer an economically viable skill for most programmers at most companies.“ Jens stimmt zu. Er hat in den letzten Monaten so gut wie keinen Code mehr von Hand geschrieben. Das erschreckt ihn ein bisschen, bereuen tut er es nicht: Es geht viel schneller, und er kann sich auf die Entscheidungen konzentrieren, also was entwickelt wird, wie und mit welcher Architektur. Den Skill will er nicht verlieren, ahnt aber, dass er weniger wird, weil er ihn seltener braucht.
Christoph ist froh, dass es bei Texten zumindest für ihn noch nicht so weit ist: Die KI draftet, er geht drüber, damit es nach ihm klingt. Code ist für ihn ein Sonderfall, weil er so gut dokumentiert ist, eine ideale Knowledge Base. Gäbe es diese Dokumentation auch anderswo, würden seiner Meinung nach noch ganz andere Bereiche schon komplett agentisch funktionieren.
Local SEO und GEO 2026: ein Workflow für kleine Unternehmen
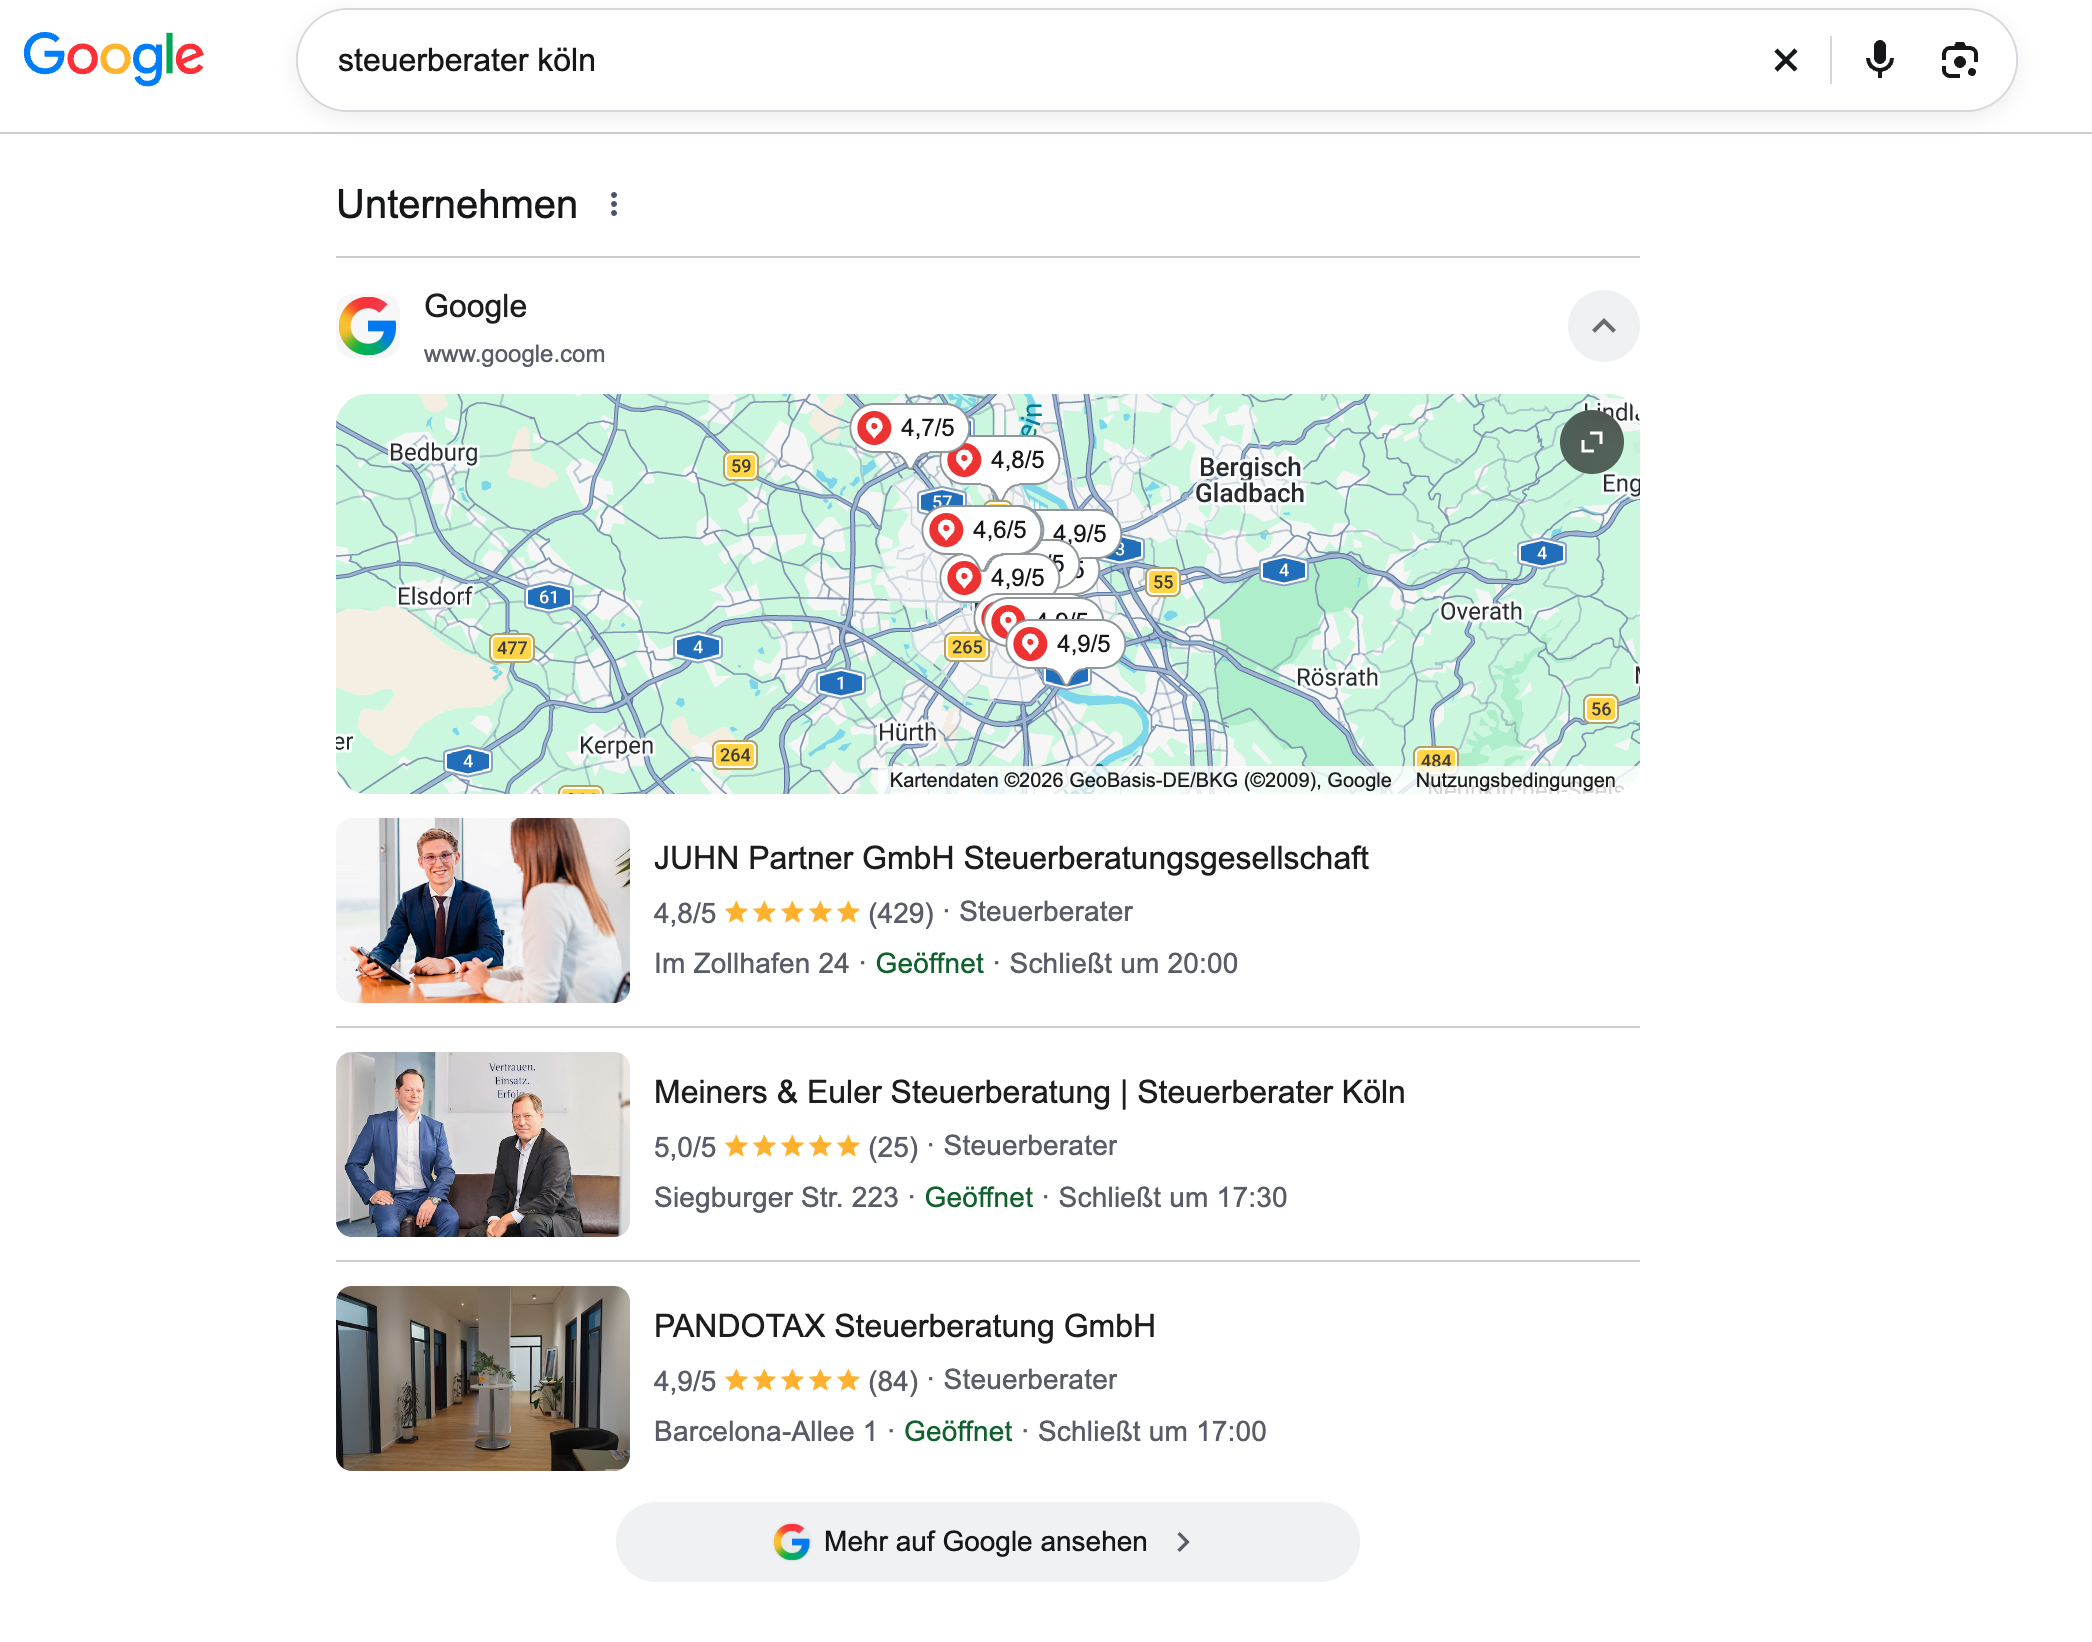
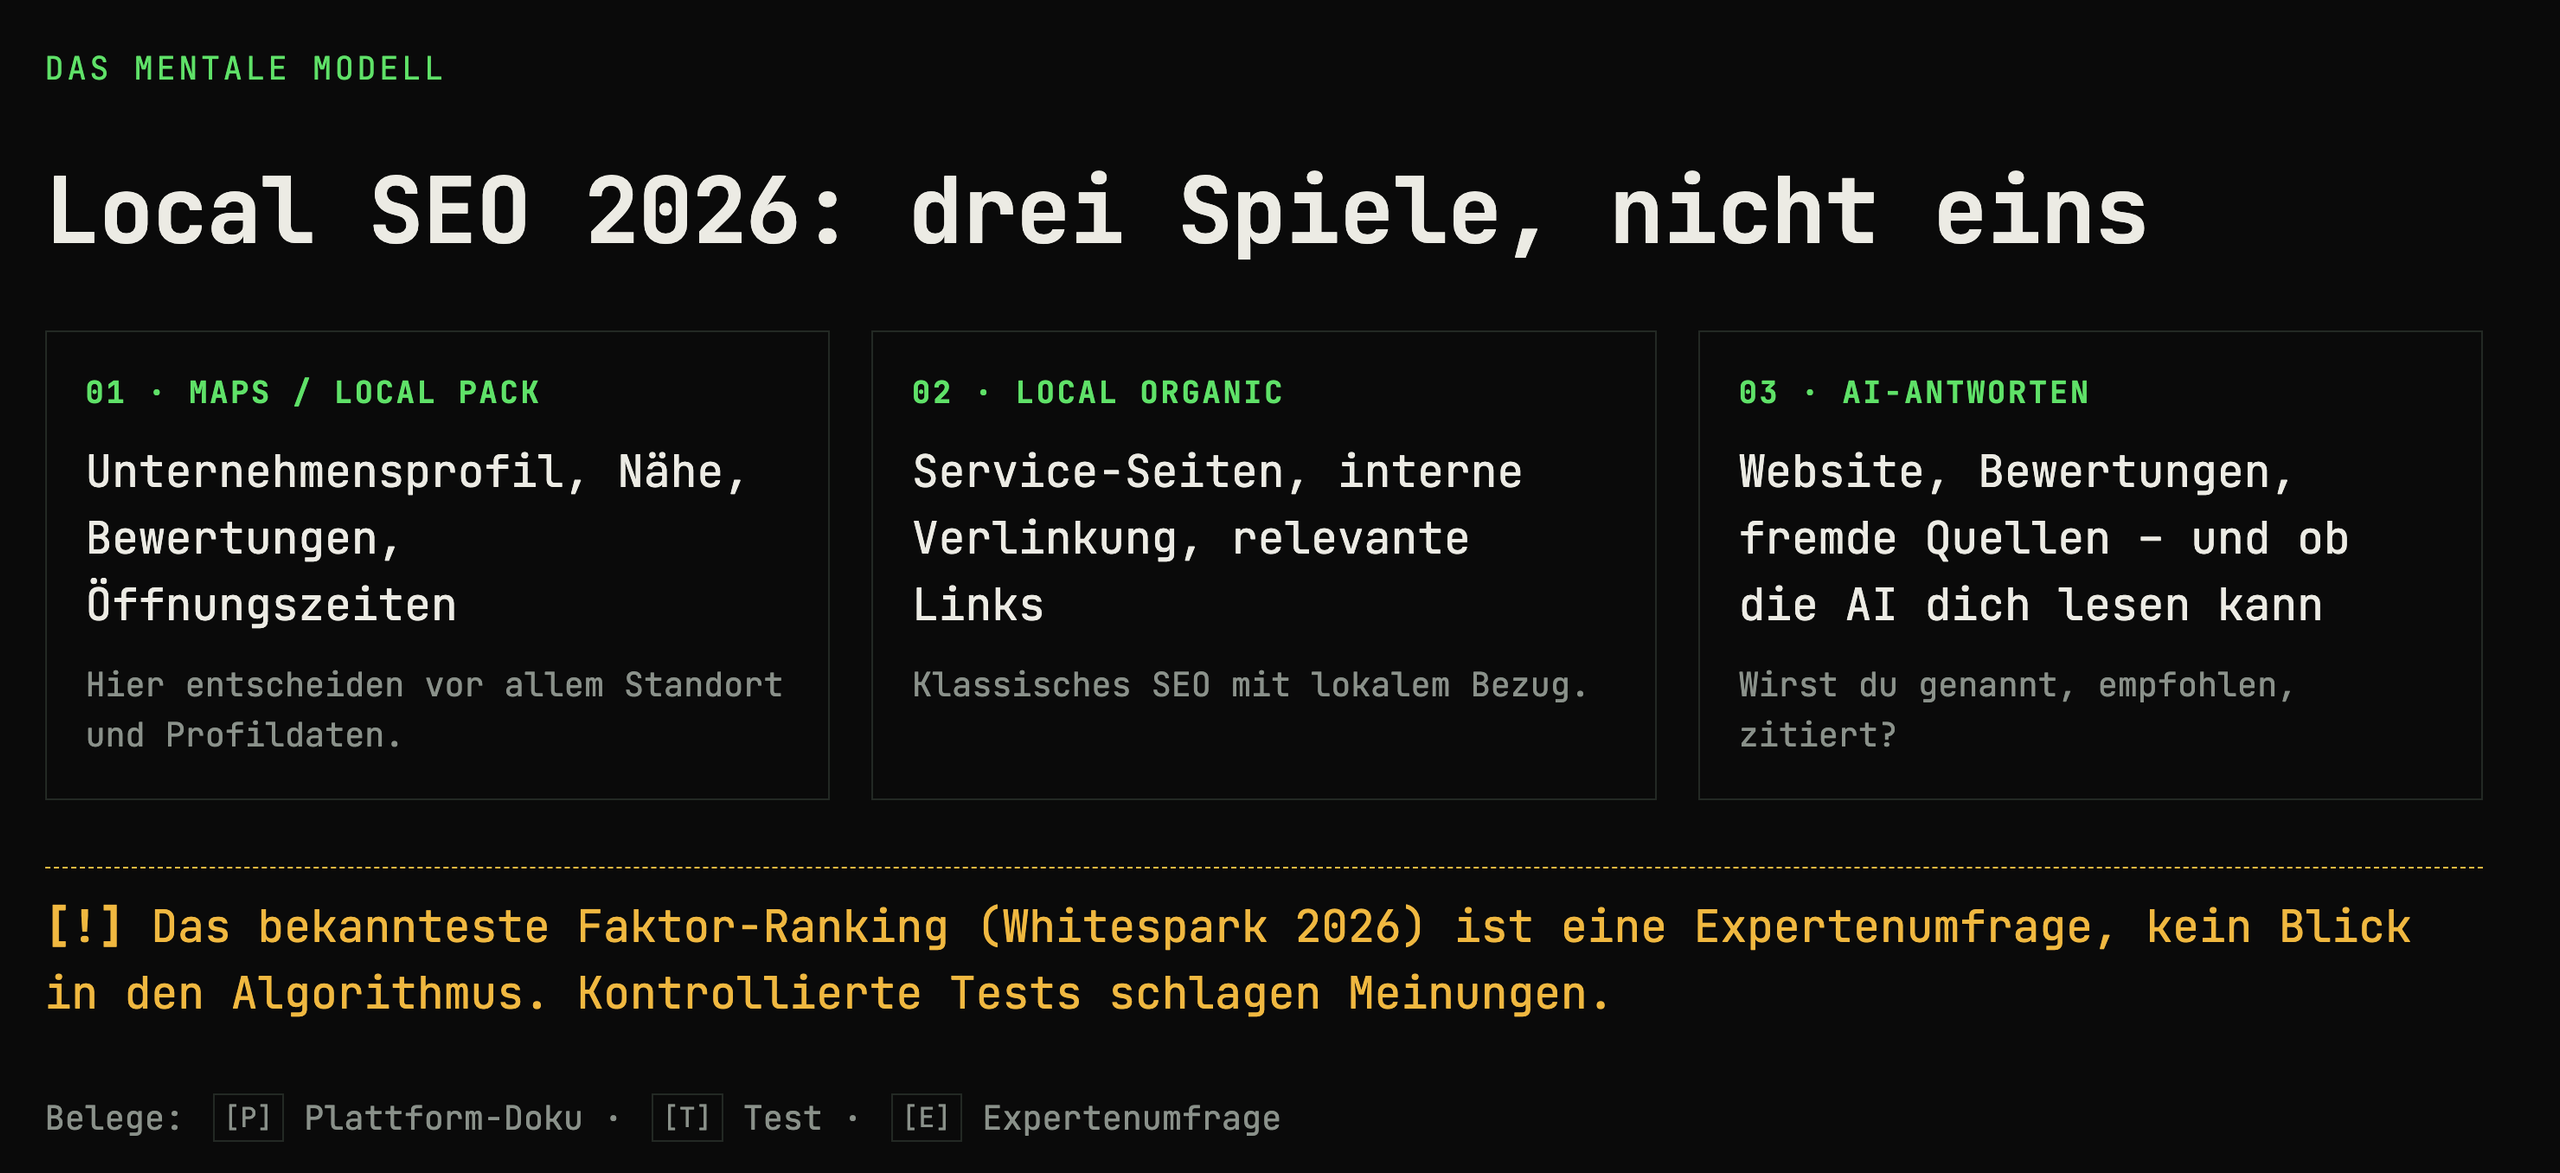
Christophs Ausgangspunkt: Wer hier zuhört, hat meist kein Local Business, wird aber aus dem Bekanntenkreis gefragt. Deshalb zeigt er in knapp 15 Minuten, wie es 2026 funktioniert. Zuerst muss man verstehen, dass es drei Bereiche gibt. Erstens Maps und das Local Pack: Bei „Steuerberater Köln“ kommen eine kleine Karte und die Top 3. Zweitens Local Organic: Bei „Steuerberater Kosten GmbH“, gesucht aus Köln, erscheinen lokale Ergebnisse in der normalen Suche. Drittens die AI-Antworten: Auf eine echte Frage wie „Welchen Steuerberater in Köln würdest du für eine GmbH empfehlen?“ antwortet die KI direkt.
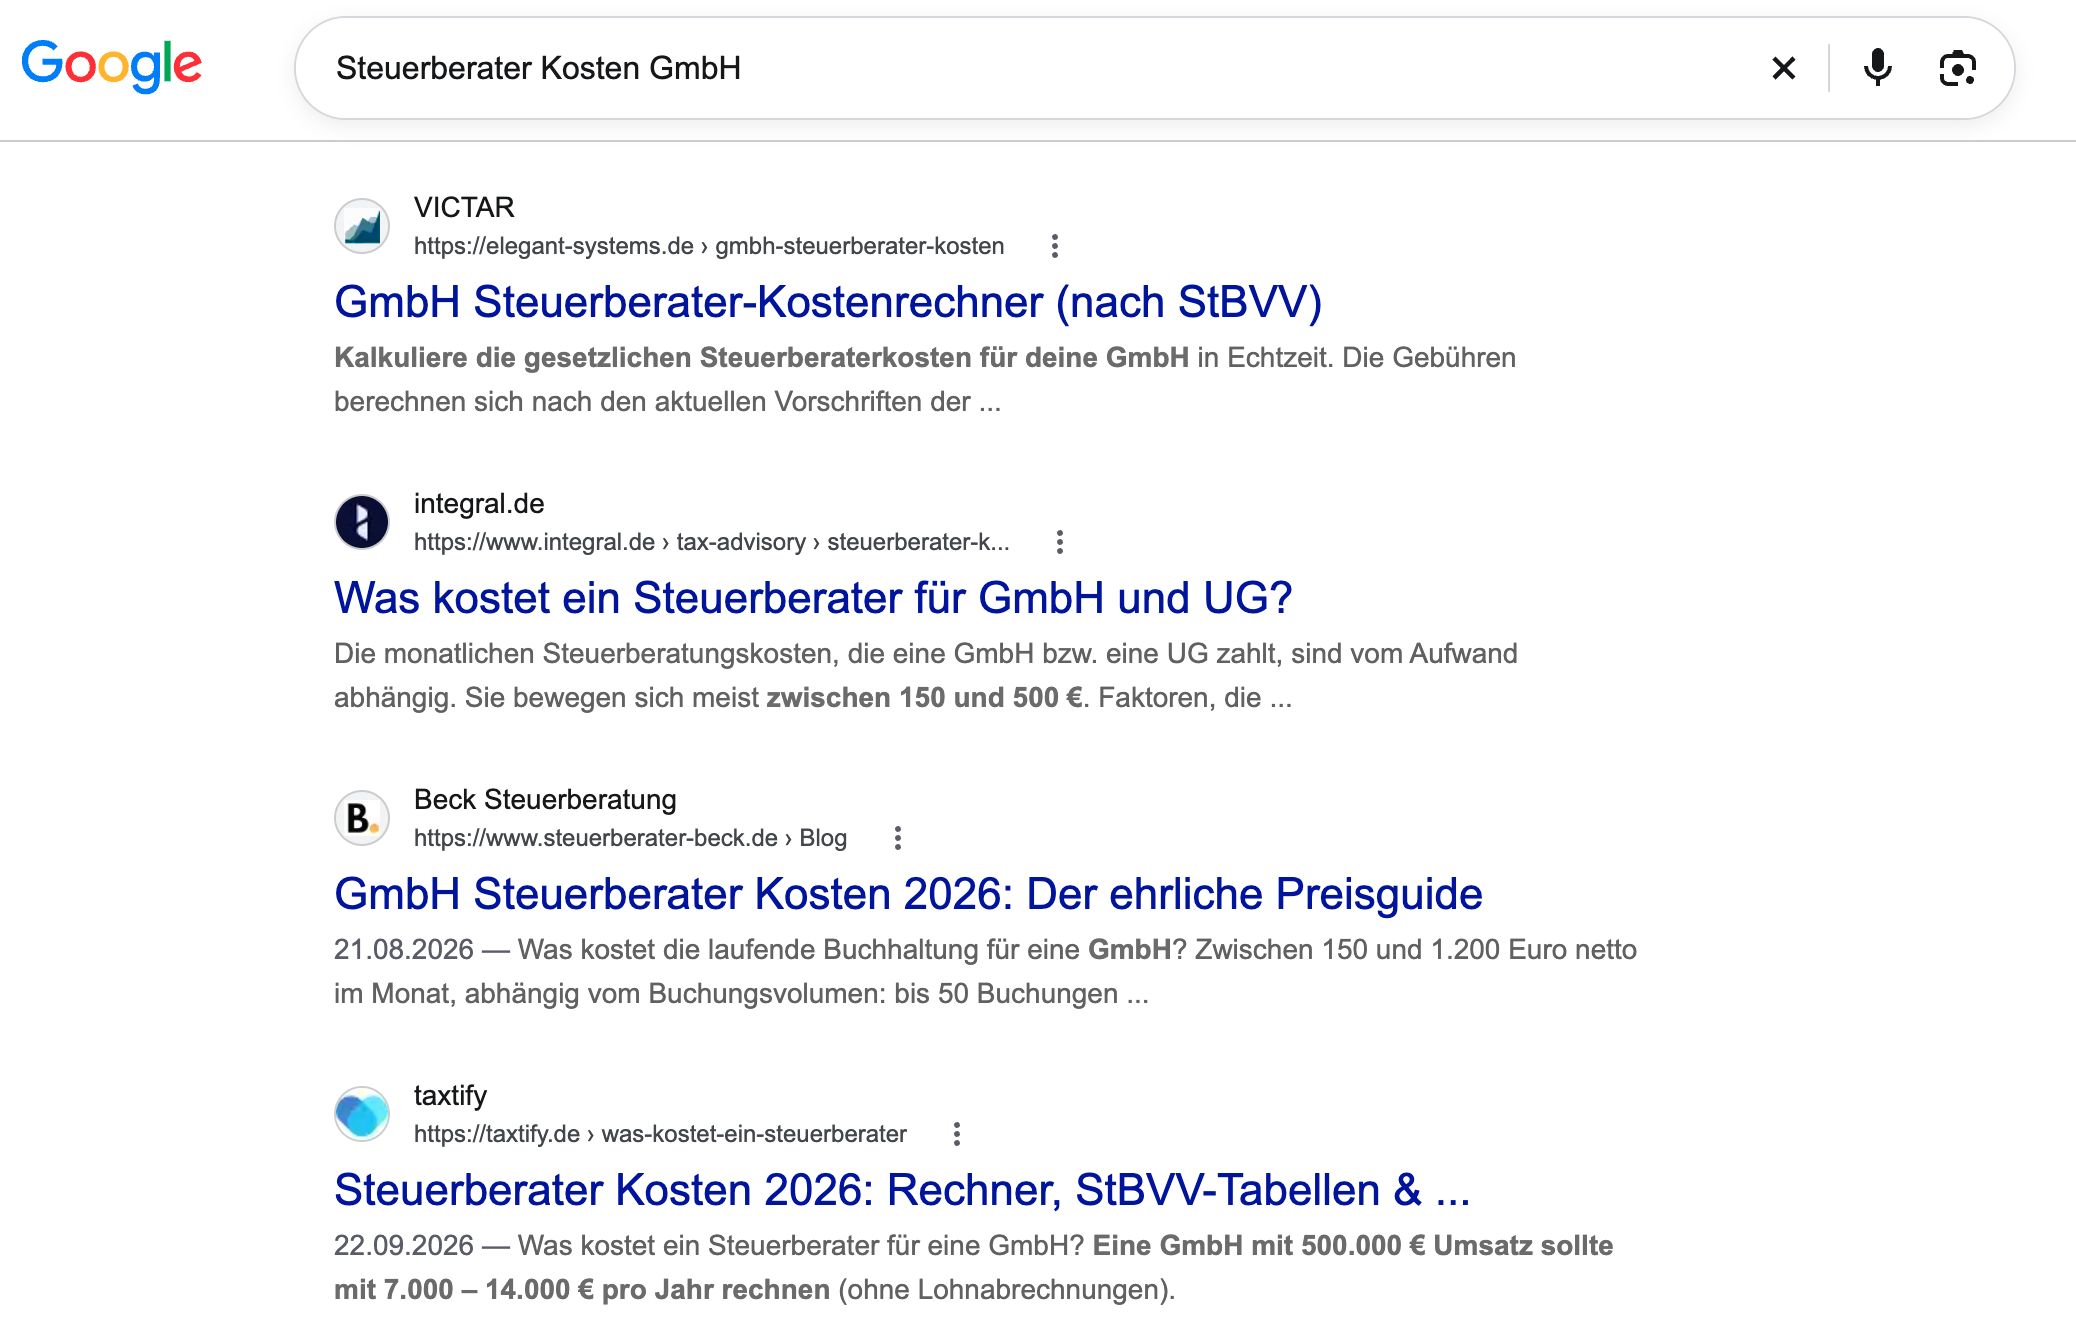
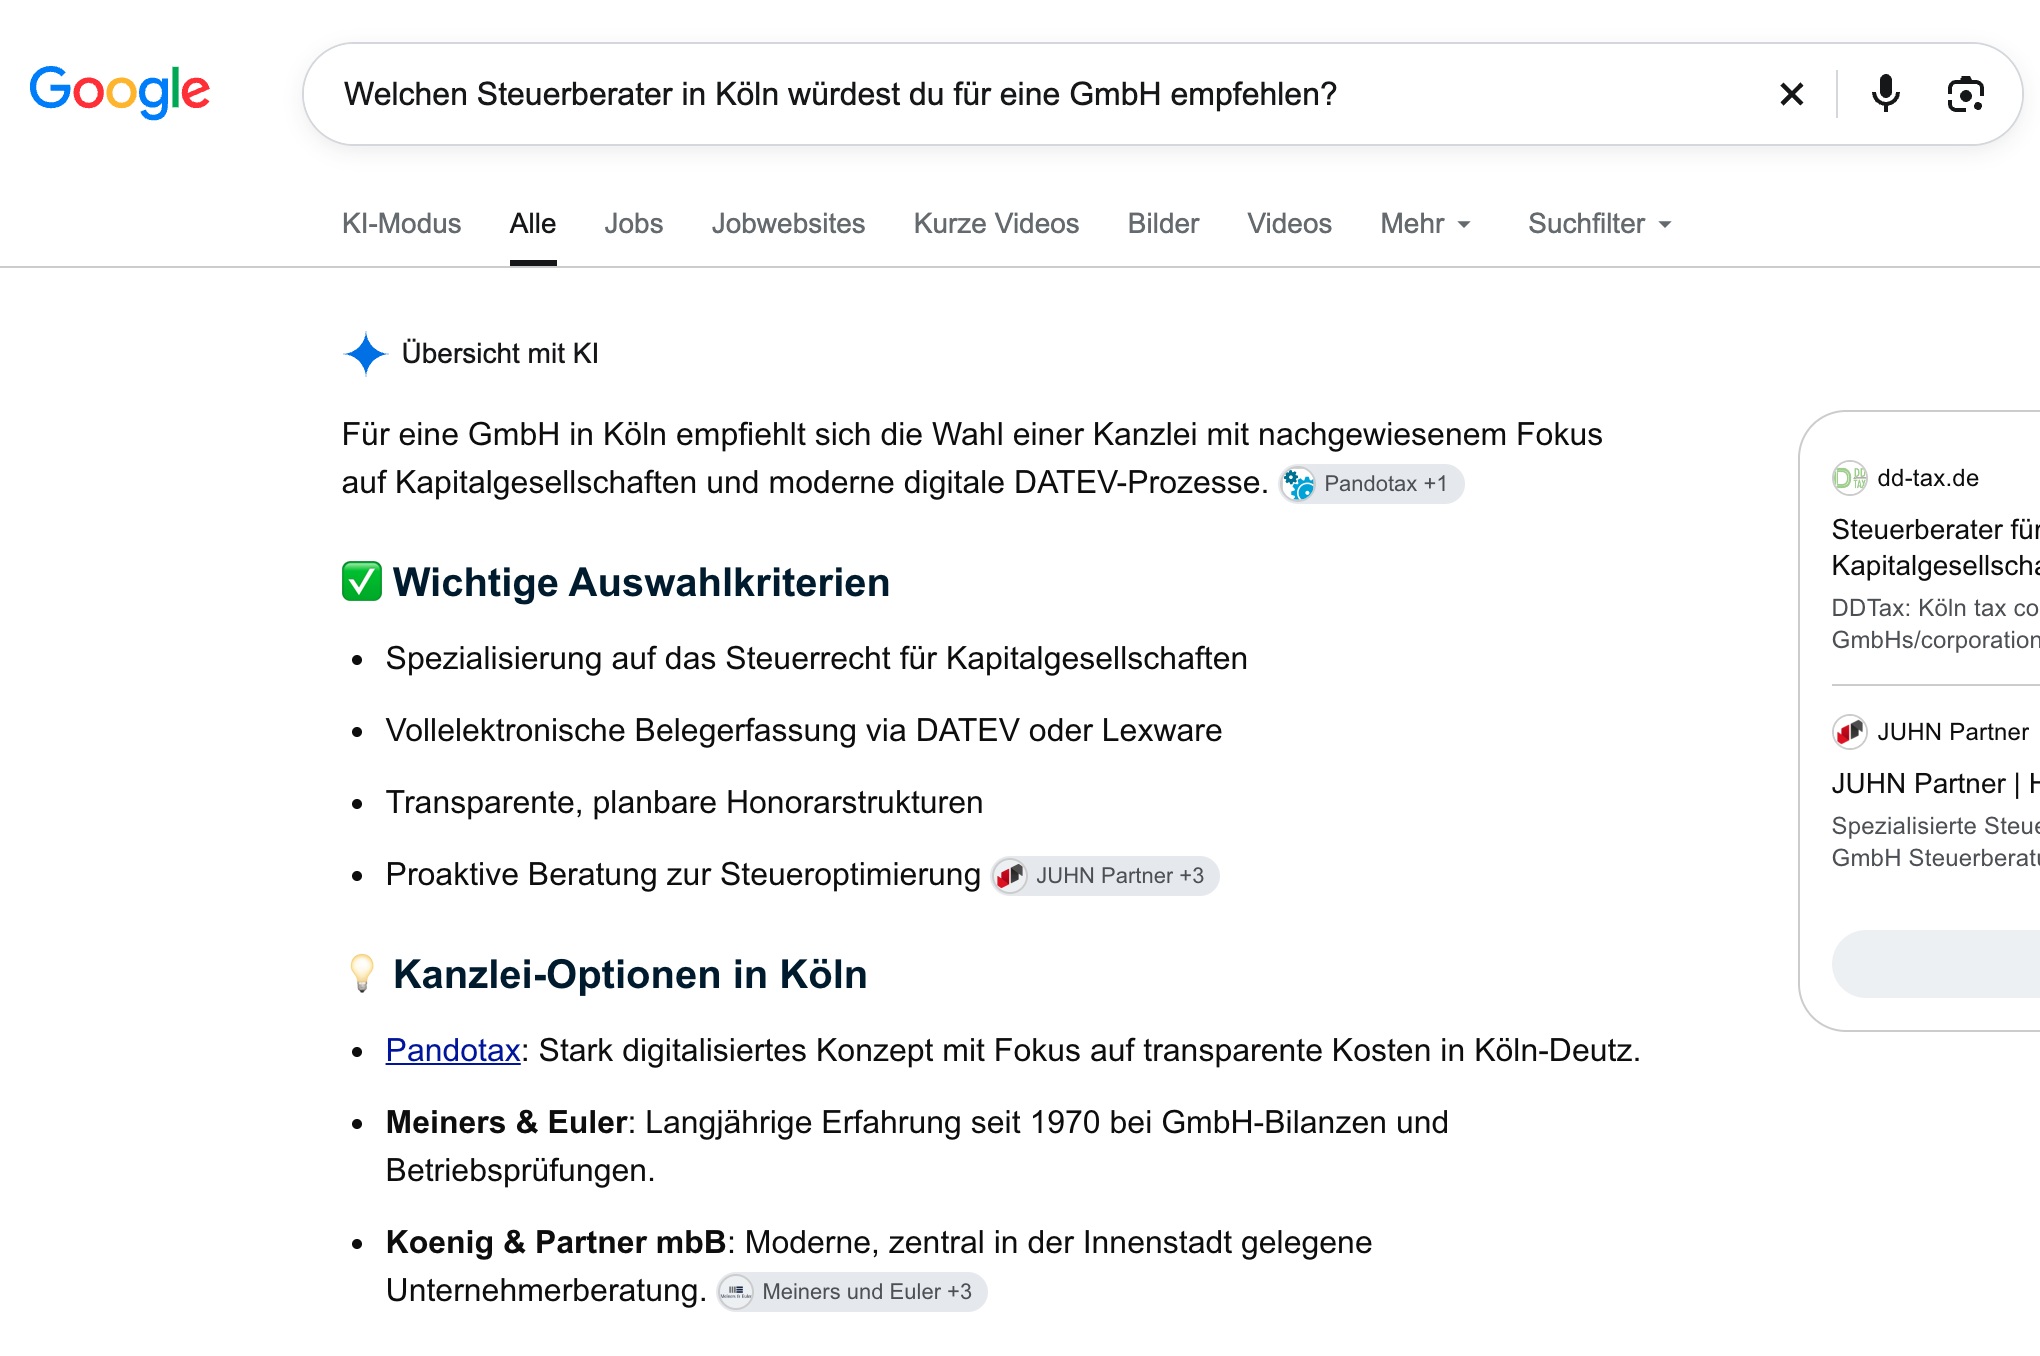
Ein Hinweis zu den bekanntesten Ranking-Faktoren: Die Studie von Whitespark, die jedes Jahr erscheint, ist eine Expertenumfrage und kein kontrollierter Test. Eins zu eins übernehmen sollte man sie also nicht.
Der Ablauf hat sechs Schritte, und der Prozess beginnt am Ende wieder von vorn. Er ist aber keine Lebensaufgabe: Man arbeitet ihn einmal durch, lässt alles vier bis sechs Wochen ruhen und schaut dann wieder hin. Ohne Baseline lassen sich keine Effekte messen. Christoph definiert für ein kleines Unternehmen etwa zehn Queries, prüft sie bei Google und in der KI und schreibt sauber auf, wo man steht. In der KI testet er dieselbe Frage nicht einmal, sondern 20- oder 30-mal, damit das Ergebnis belastbar ist. Genau darum geht es auch in der Software, die er gerade baut.
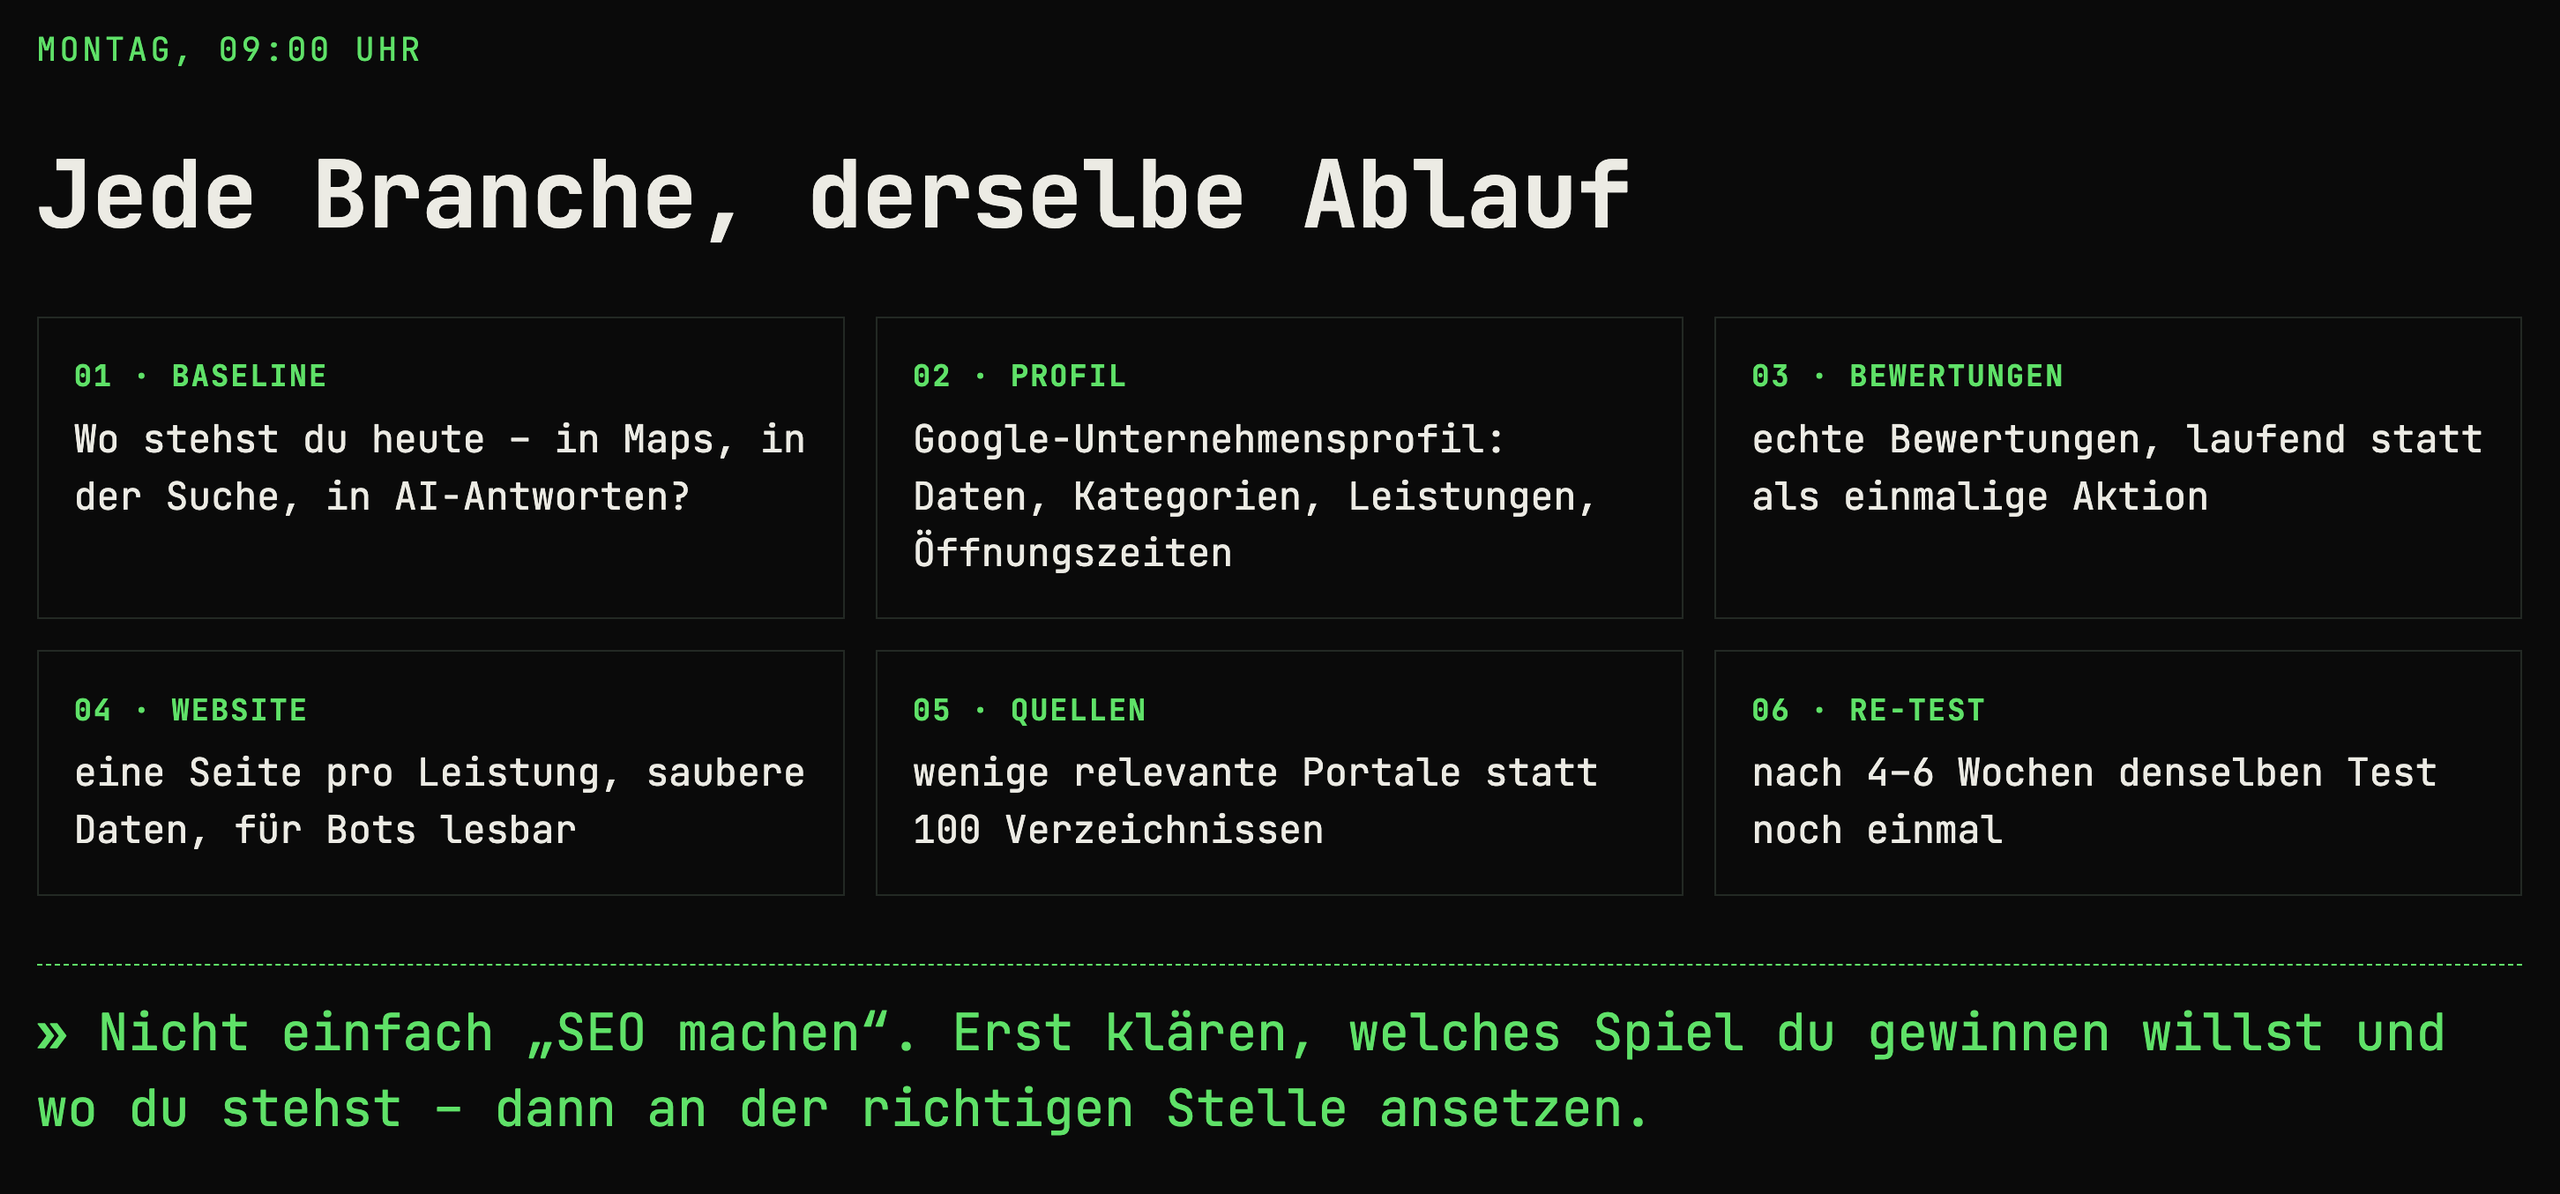
Das Google-Unternehmensprofil kommt zuerst, und das wird sich so schnell nicht ändern. Christoph sieht es als Datenbankeintrag, nicht als Newsfeed, gerade weil KI mit Entitäten arbeitet: korrekte Adresse, richtige Telefonnummer, alle Felder ausfüllen, sich Zeit lassen. Überschätzt werden dagegen regelmäßige Beiträge und Keyword Stuffing im Profiltext. Wie viel das Profil wert ist, hat ihm sein Friseur in Köln erzählt: Beim Verkauf eines Ladens ist ein gutes Profil mit vielen Bewertungen locker 30.000 bis 40.000 Euro wert. Jens fragt nach, weil eine Kundin wissen wollte, ob sie ihre Instagram-Beiträge auch im Profil teilen soll. Christophs Antwort: fürs Ranking nicht, da bewegen Beiträge laut Studien keine Nadel. Um Aktivität zu zeigen, ja.
Bei den Bewertungen gelten etwa zehn als Schwelle, wichtiger sind aber stetig frische. Also einen Prozess bauen, in dem Kunden aktiv nach einer Bewertung gefragt werden, ohne Gegenleistung, Rabatte oder Geschenke. Bewertungen kaufen ist keine Option: Gefälschte Bewertungen sind in Deutschland verboten, und Google erkennt immer mehr. Dann ist das Profil von heute auf morgen weg oder bekommt keine Reichweite mehr.
Auf der Website sind 80 Städteseiten mit immer gleichem Text vorbei. Besser ist eine Seite pro Leistung, sauber beschrieben, mit echten Ansprechpartnern, Qualifikationen und Belegen, warum man gut ist. Den Umkreis decken die Entitäten ab. Technisch gehört das LocalBusiness-Schema dazu. In der robots.txt sollte man prüfen, ob der OpenAI-Searchbot Zugriff hat, denn er hält sich daran. Christoph hatte gerade ein Hotel als Kunden, das seit Monaten alle Bots ausgeschlossen hatte, ohne es zu wissen. Jens erinnert an Cloudflare, wo KI-Crawler eine Zeit lang per Default blockiert wurden. Christophs Rat: aktiv entscheiden, wer Zugriff hat. Und NAP, also Name, Adresse und Telefonnummer, muss überall gleich sein, damit alles derselben Entität zugeordnet wird. Datenqualität schlägt Breite.
Breite heißt meistens: tausend Verzeichniseinträge, wie man sie auf Fiverr kauft. Christoph sagt klar: nicht machen. Es reichen die Standards, also das Google-Unternehmensprofil, Apple Business Connect für Karten und Siri und Bing Places. Danach wird es lokal: Verbände, das Stadtportal, die lokale Presse. Für GEO kommt nur ein Schritt dazu: Prompts mehrfach testen, schauen, welche Quellen die KI immer wieder nutzt, und dafür sorgen, dass man dort auftaucht. Damit hat man fast alles getan, was man tun kann. Local SEO und Local GEO sind für Christoph im Kern dasselbe.
Ein allgemeiner Punkt zum Schluss: Die Zahl der Besucher bringt kein Geld, genauso wenig wie Follower auf Instagram. Christoph sieht bei Kunden oft, dass Impressionen und Klicks sinken, während die Qualität der Besucher steigt und das Telefon klingelt. Also keine kalten Füße, wenn der Traffic zurückgeht. Was er nicht mehr machen würde: Verzeichnis-Pakete für 5 Dollar, 100 identische Landingpages für jeden Stadtteil, ein Abo dafür, dass das Schema-Markup aktuell bleibt (das ist ein One-Time-Job), und KI-Antworten nur einmal testen. Jens will einiges davon für seine Kunden mitnehmen.
Aus dem Thema ist inzwischen auch ein eigener Artikel geworden: Local SEO & GEO 2026: So wirst du mit einem lokalen Unternehmen bei Google und ChatGPT sichtbar, mit dem kompletten Workflow und einer Checkliste.
Jev in der Praxis: Belege sortieren für einen Cent
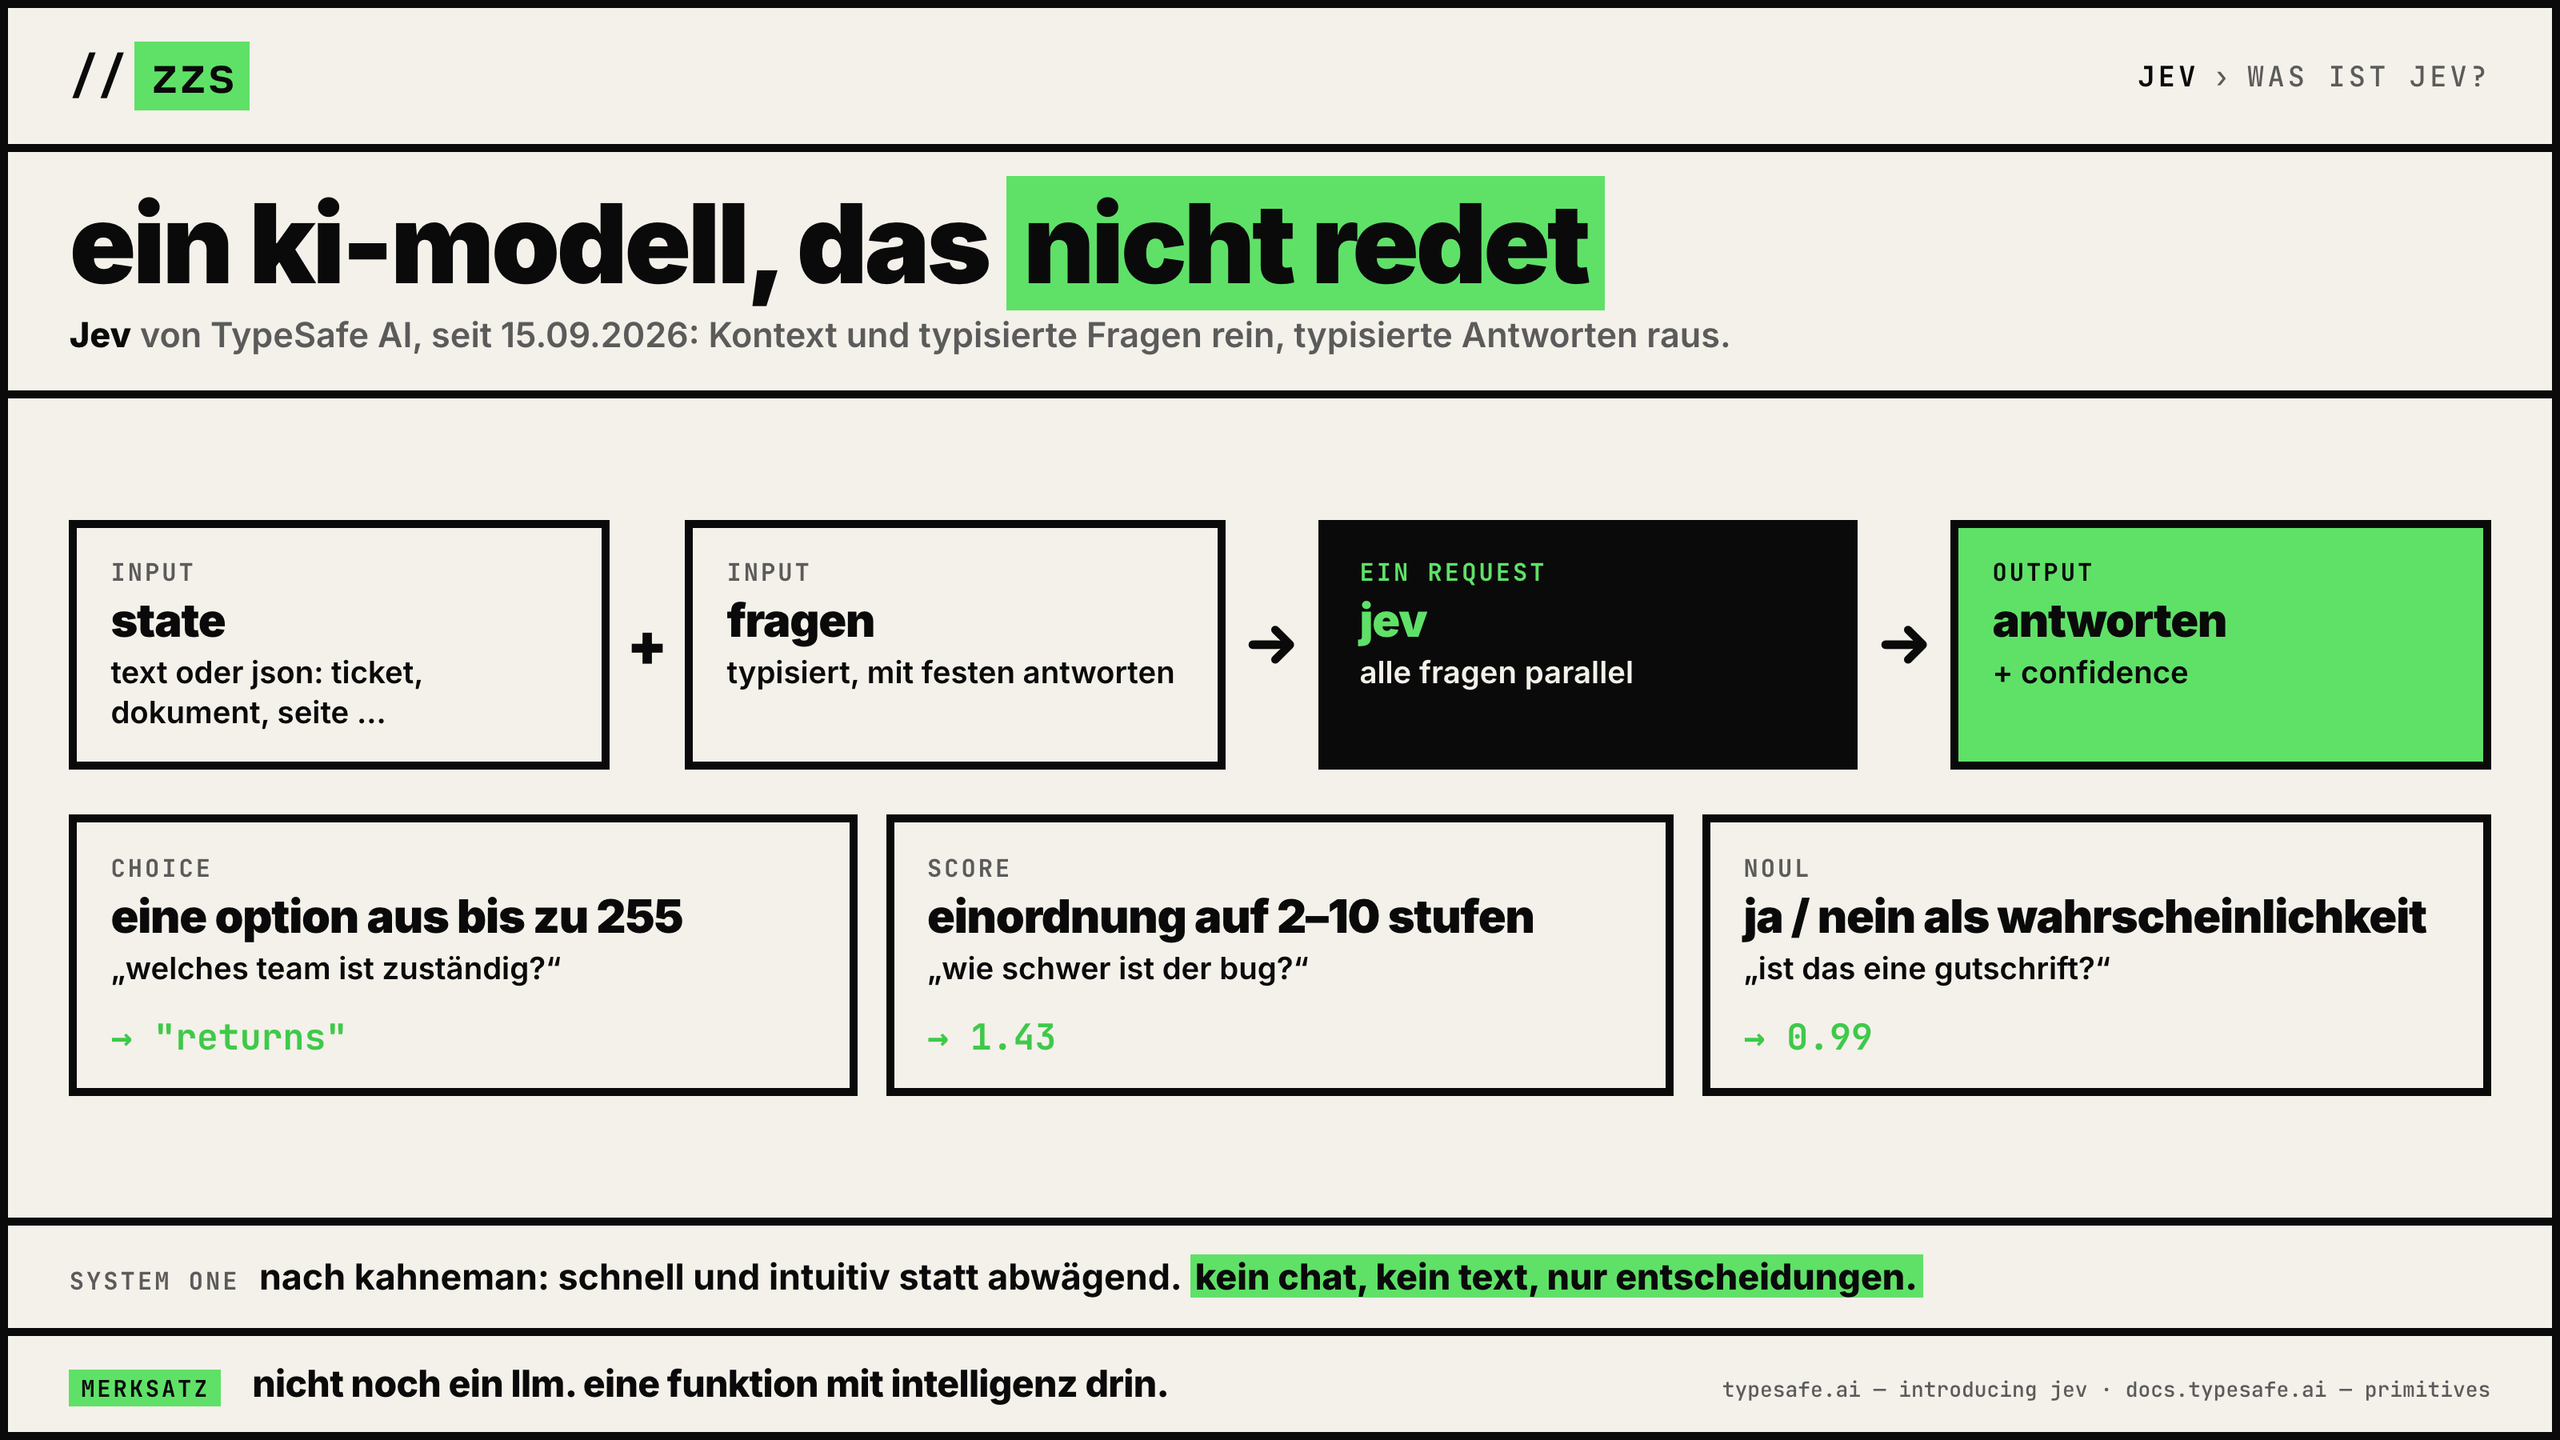
Jev von TypeSafe AI hatte Jens in Folge 11 als Snack dabei. Jetzt geht er tiefer. Seine Kurzfassung: ein KI-Modell, das nicht redet. Rein gehen ein State, etwa das, was ein Nutzer gemeldet hat, und typisierte Fragen. Raus kommen typisierte Antworten mit einer Confidence. Es gibt drei Fragetypen: Choice wählt eine Option aus bis zu 255 vorgegebenen, Score ordnet auf zwei bis zehn Stufen ein, etwa wie schwer ein Bug ist, und Noul beantwortet eine Ja-Nein-Frage als Wahrscheinlichkeit.
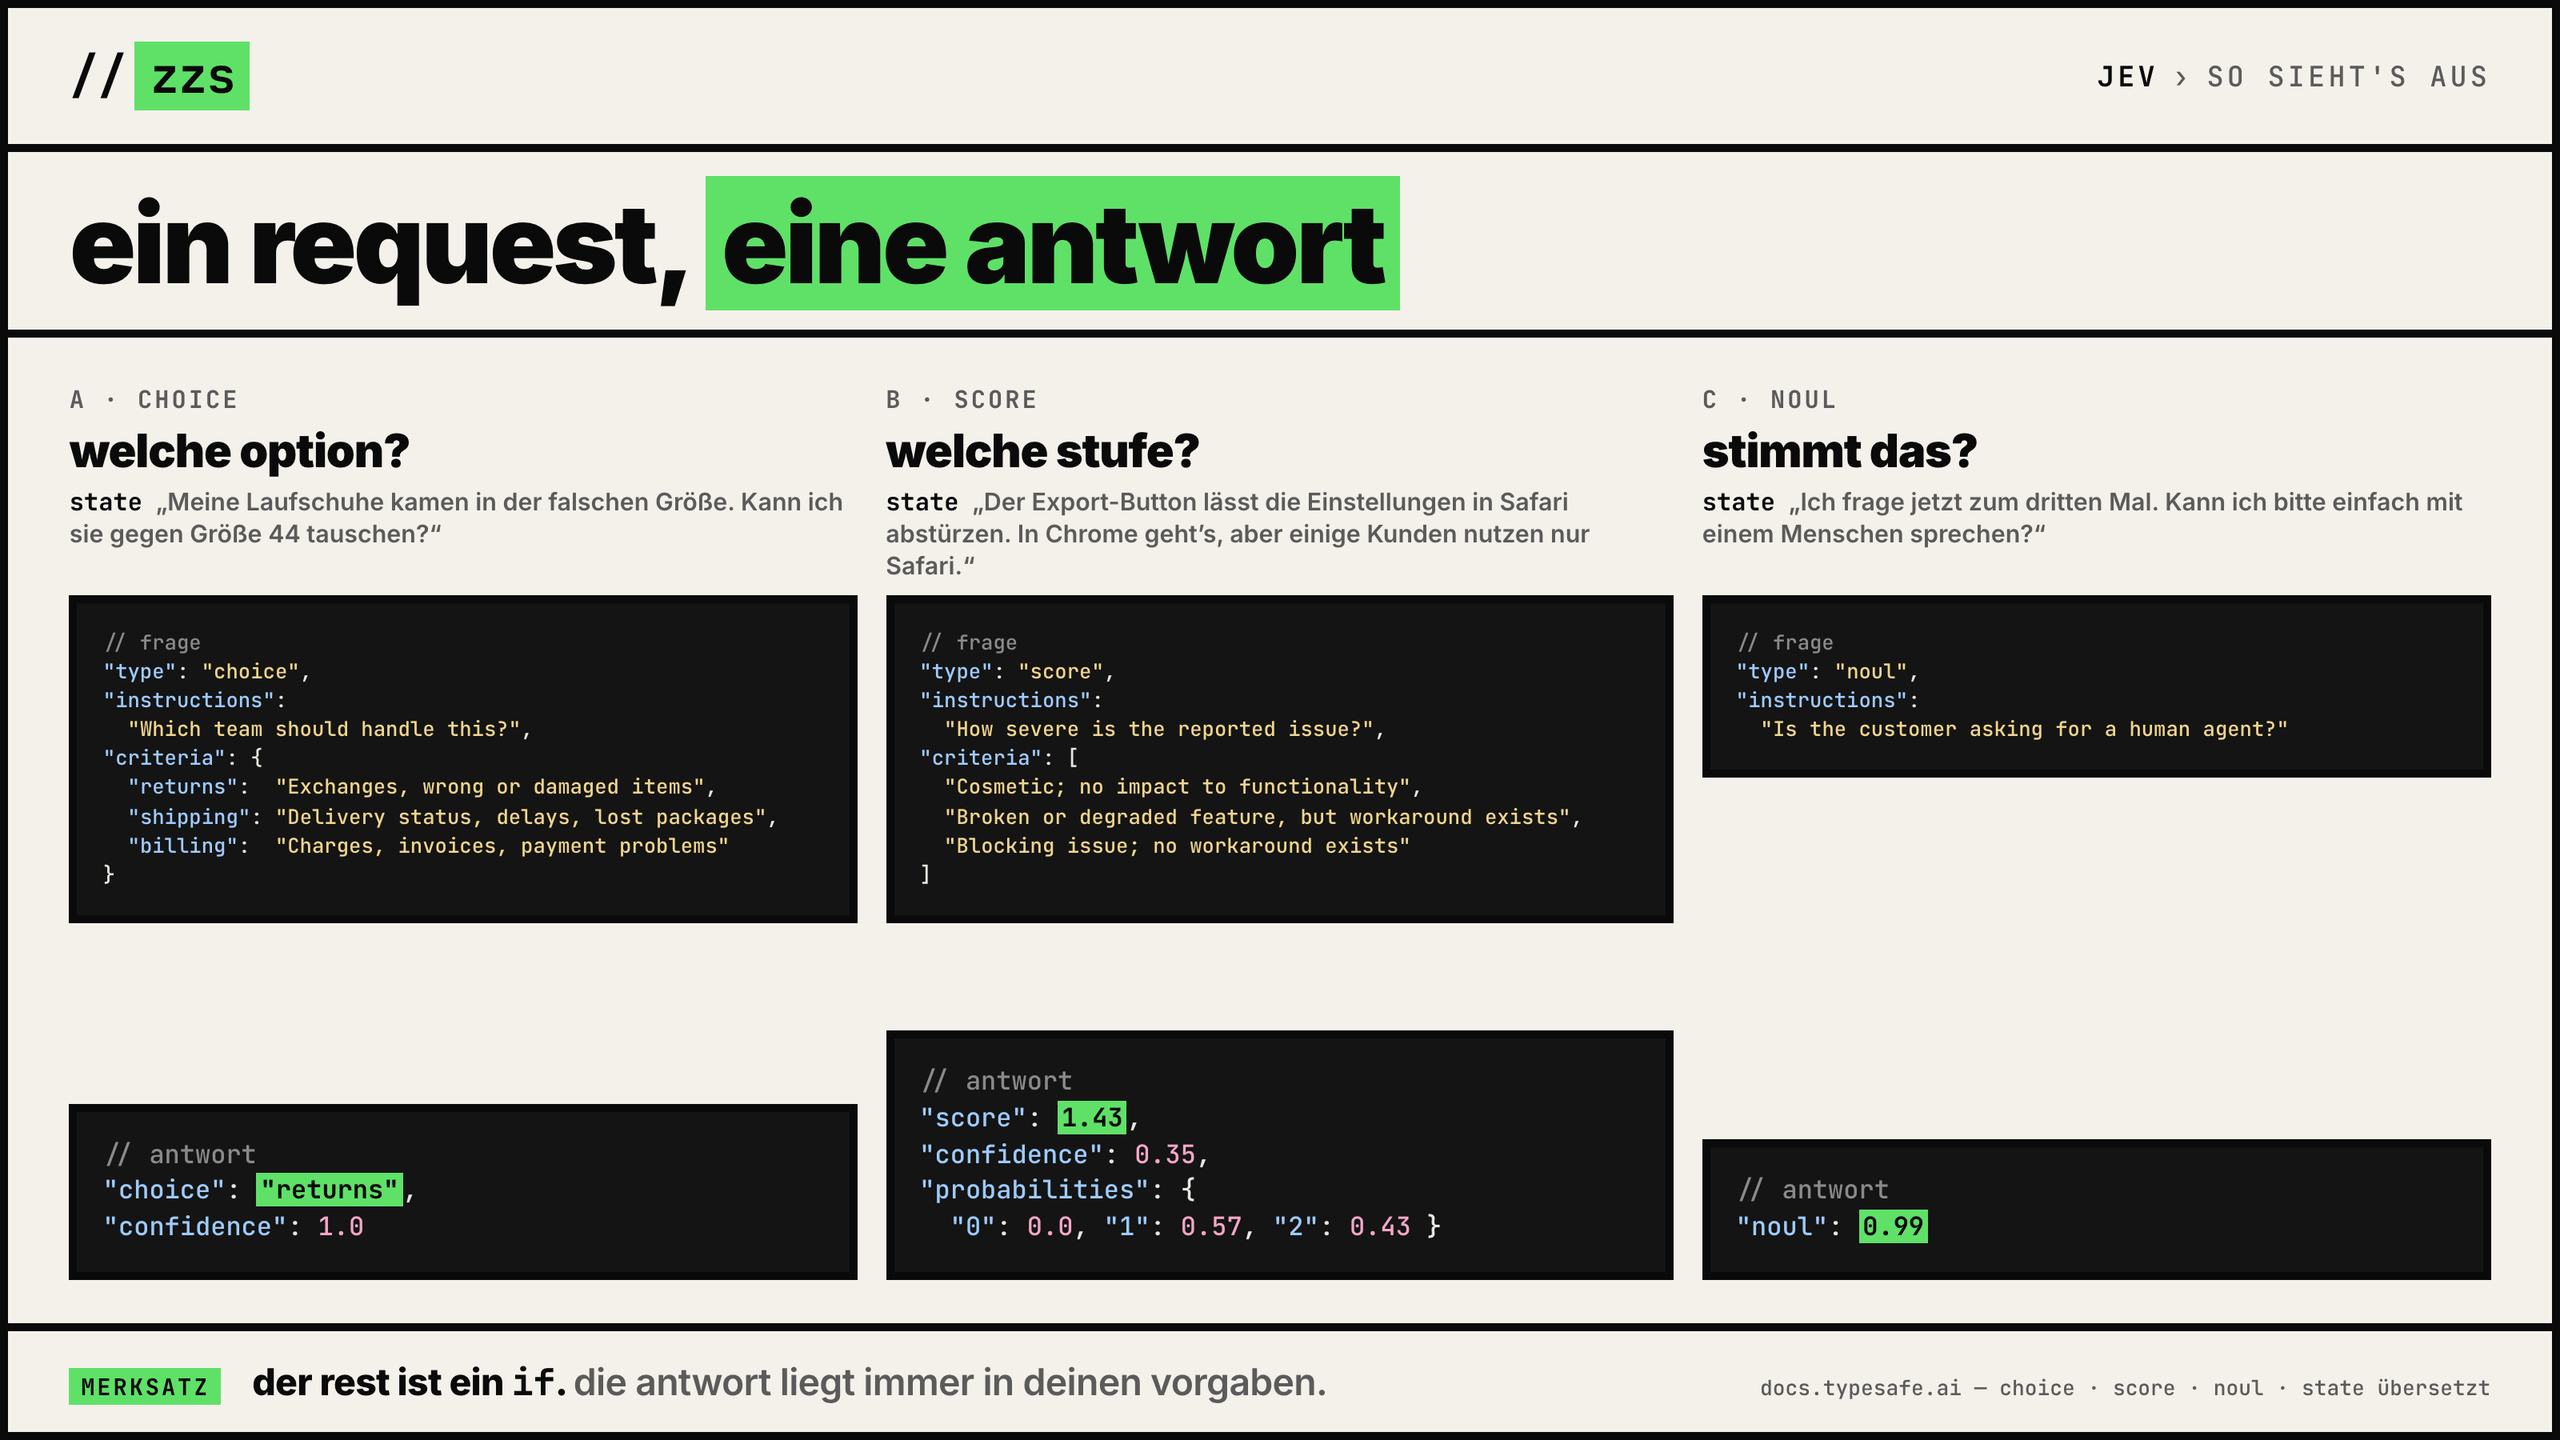
Ein Beispiel: Der State lautet „Meine Laufschuhe kamen in der falschen Größe. Kann ich sie gegen Größe 44 tauschen?“. Die Choice-Frage nach dem zuständigen Team liefert „returns“ mit einer Confidence von 1. Der Score-Modus gibt die Wahrscheinlichkeiten für jede Stufe zurück, Noul eine Prozentzahl. Christoph fragt nach: Ist das wirklich der ganze Kontext? Ja, State, Instructions und Kriterien, mehr nicht. Und es muss Text sein. Ein PDF oder Bild muss man vorher umwandeln.
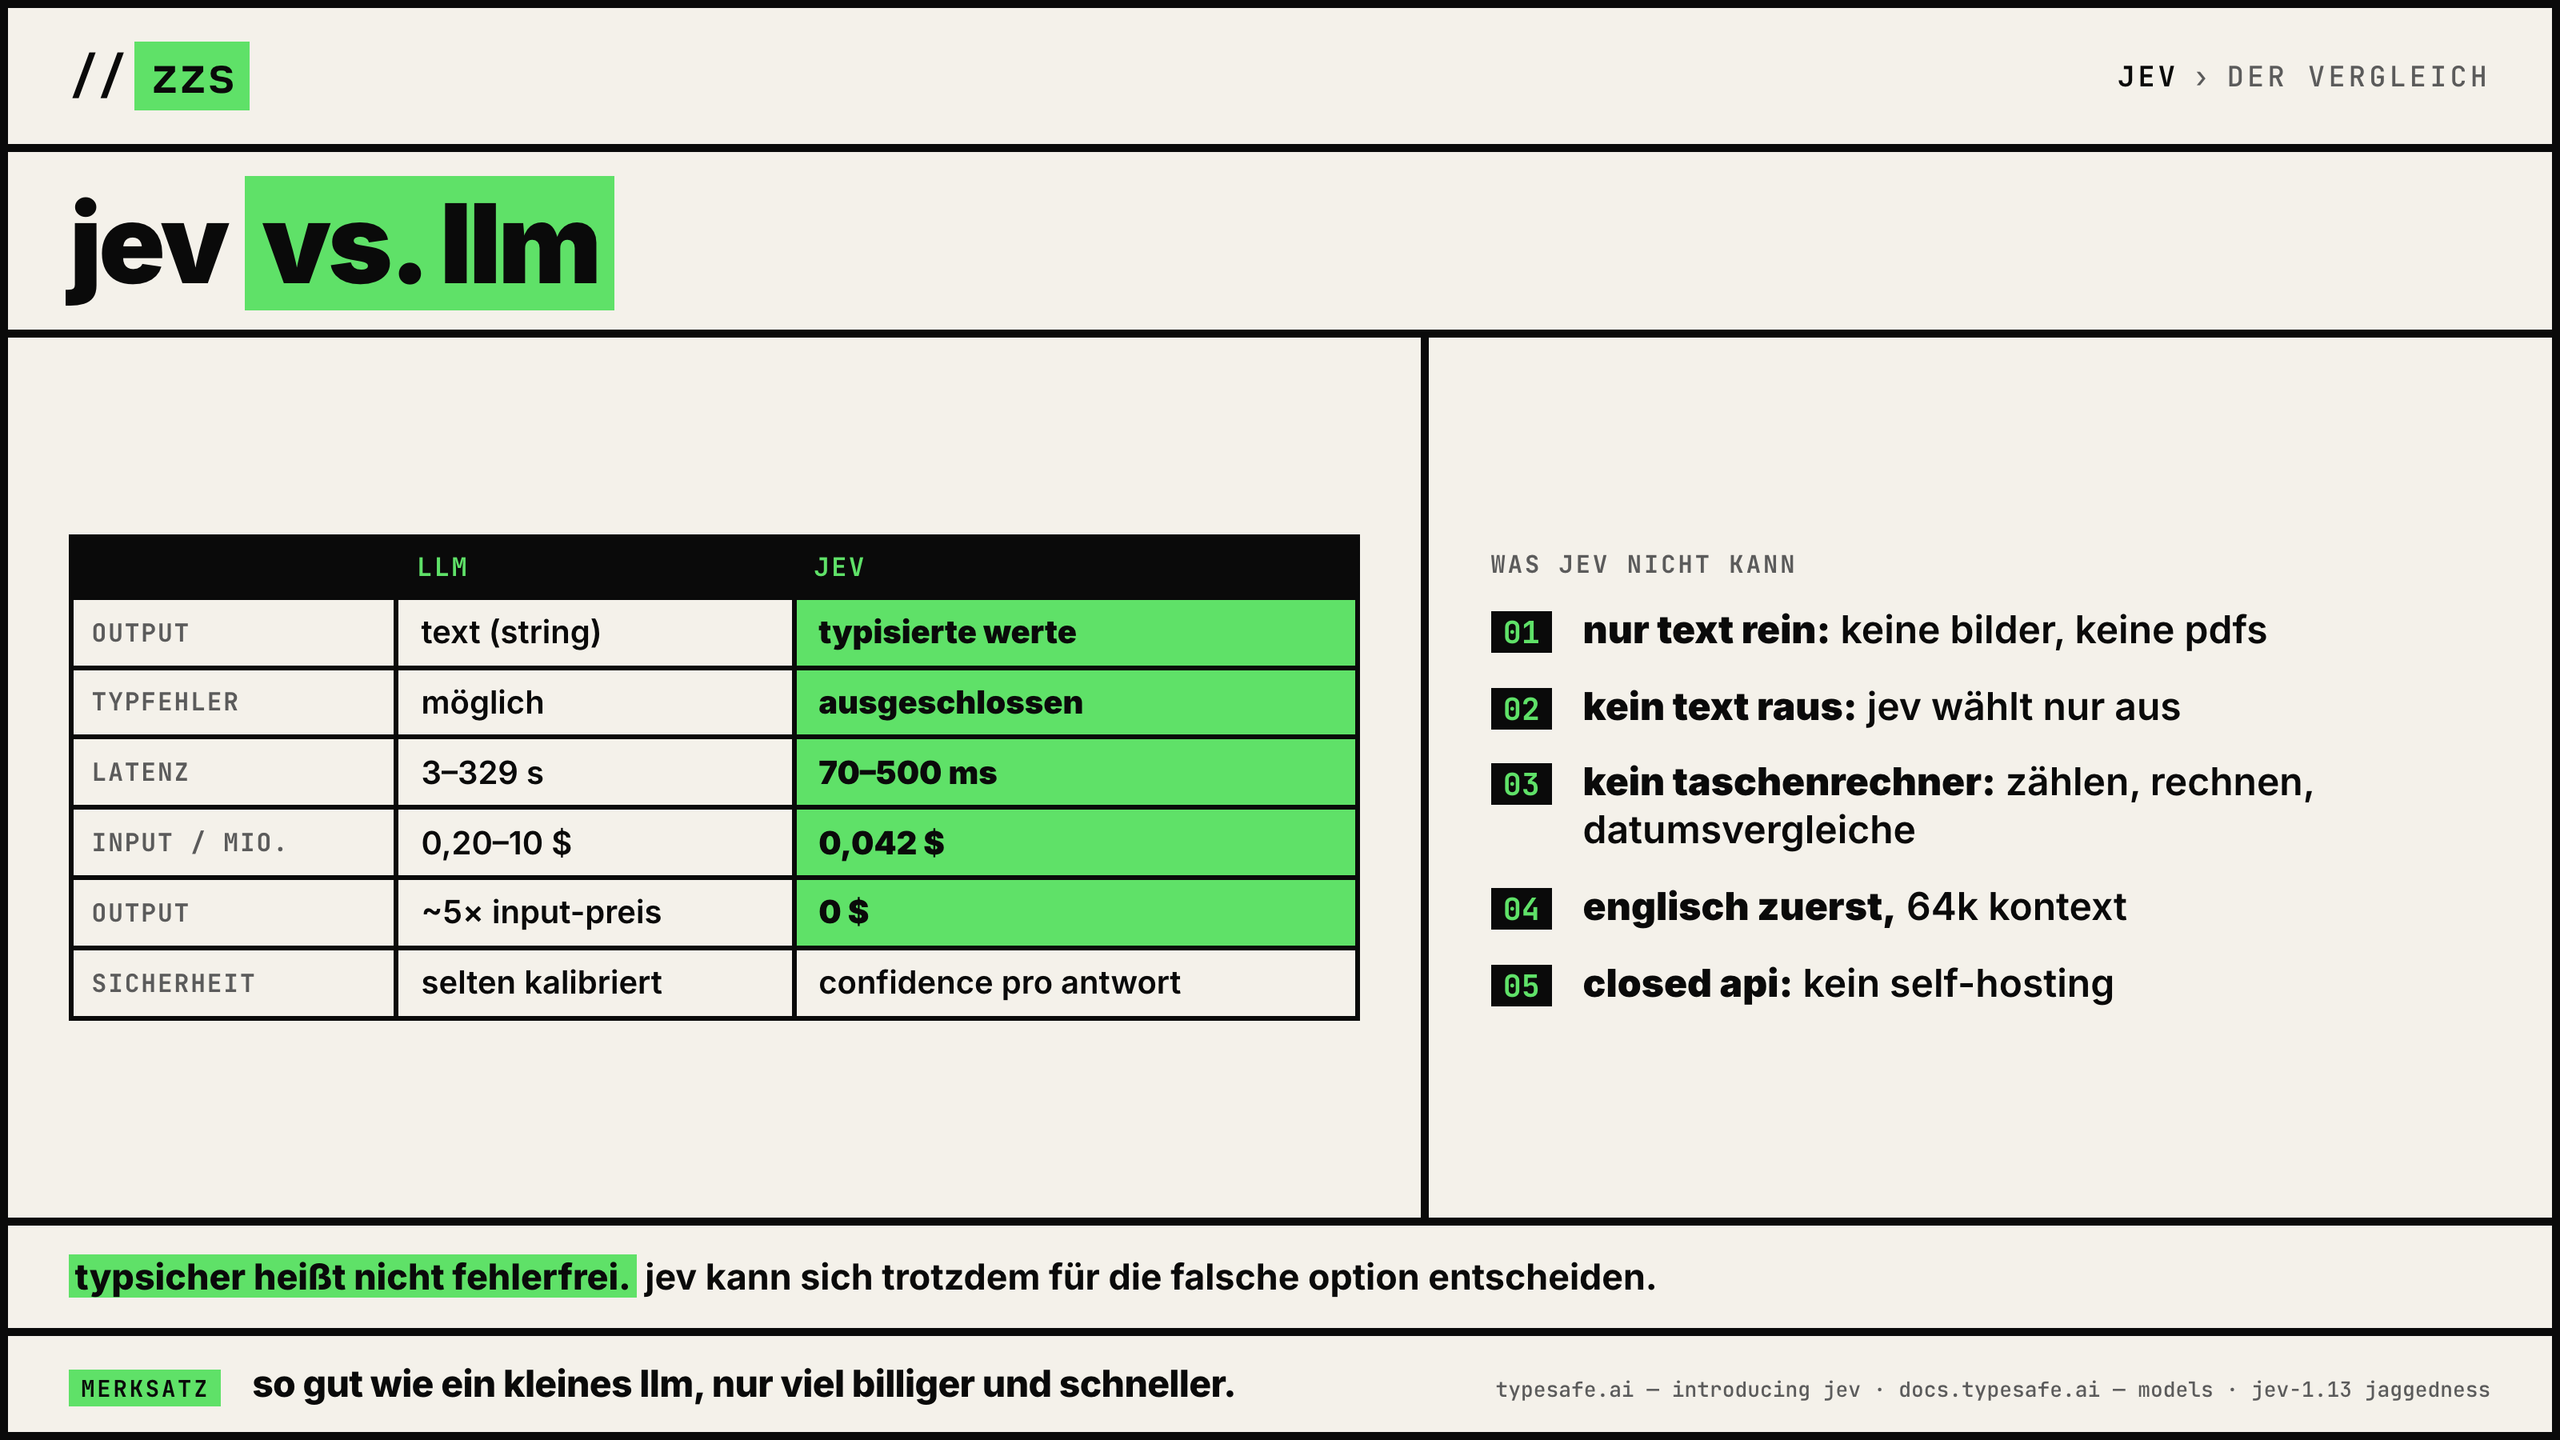
Jev ist kein Large Language Model. Es schreibt keinen Text, sondern gibt typisierte Werte in einem festen Schema zurück. Typfehler sind damit ausgeschlossen. Es ist schnell und günstig: Output-Tokens kosten nichts, Input sehr wenig. Weil Jev so eingeschränkt ist, sind die Antworten deutlich verlässlicher als bei einem LLM. Fehlerfrei ist es trotzdem nicht, prüfen muss man weiterhin.
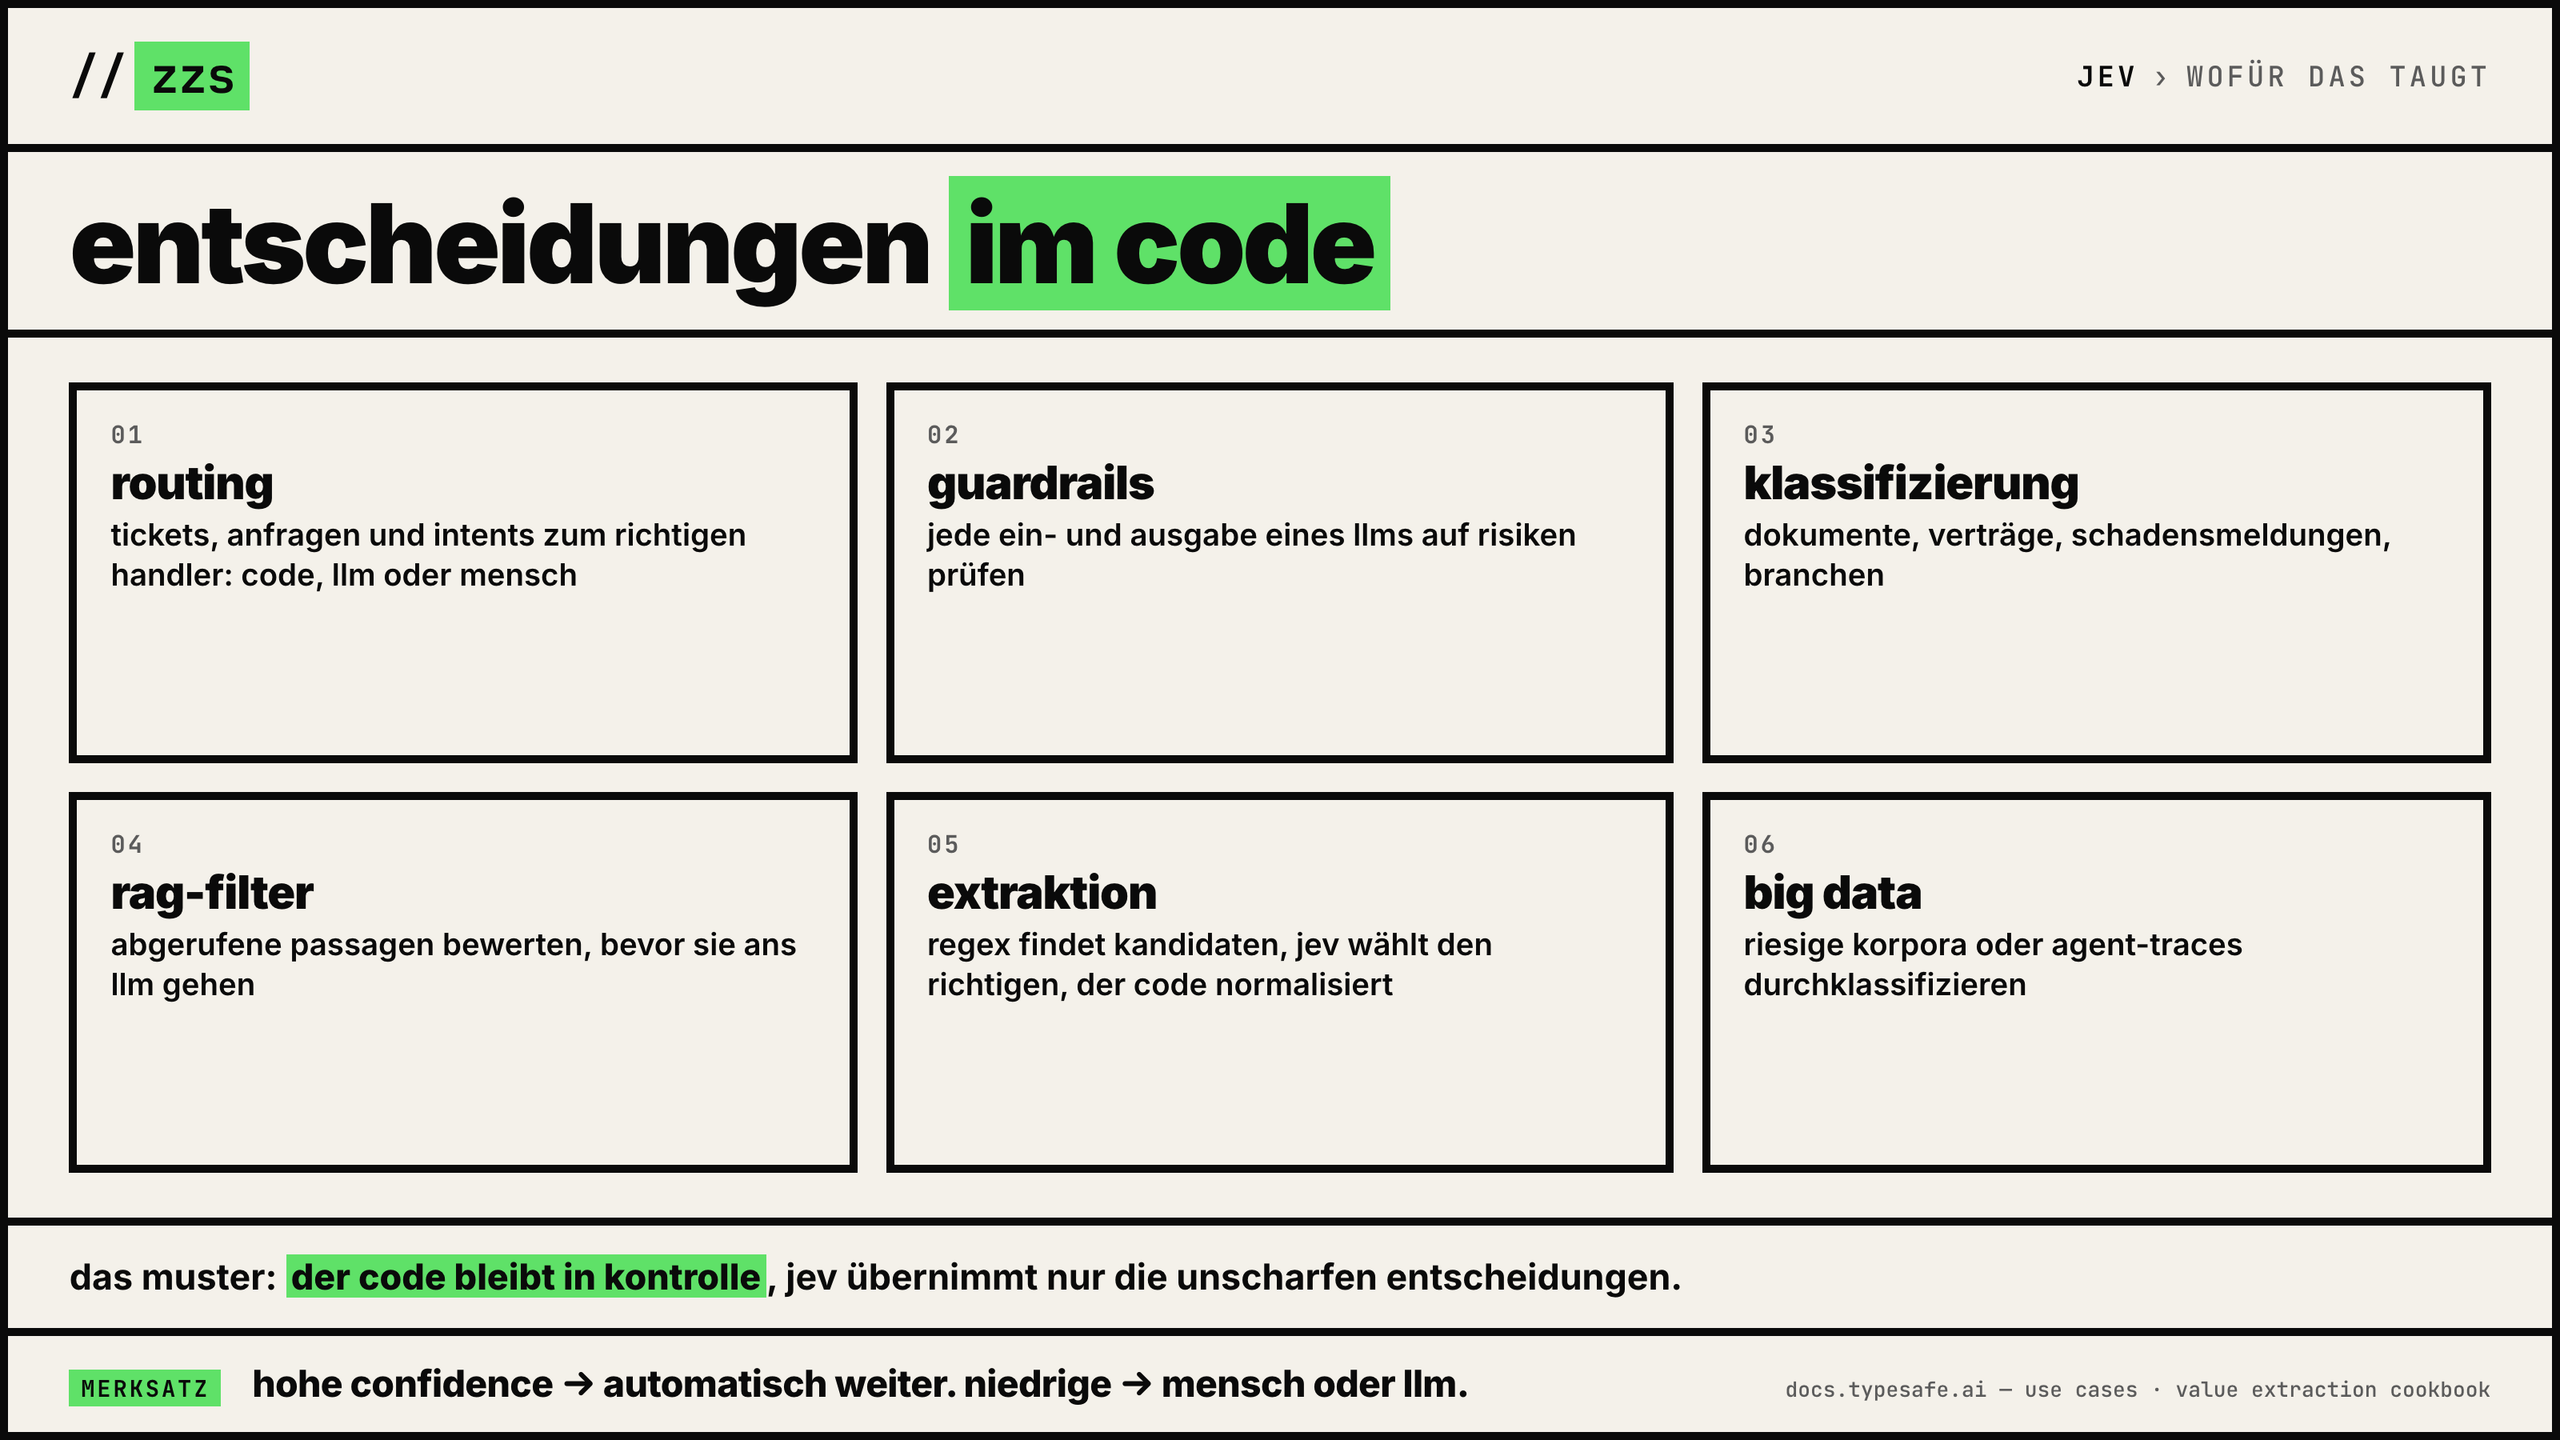
Was andere damit bauen, sammelt jevusecases.com, inzwischen über 1.000 Projekte, oft als Ersatz für ein bezahltes Tool. Jens zeigt Browser Use Jev Ultrafast: ein Browser-Agent, der über die Oberfläche von Google Flights einen Flug sucht, deutlich schneller als mit einem LLM. Christoph würde Screenshots machen. Jens rät davon ab: Bei Browser-Automation besser über den DOM und den Accessibility Tree gehen, da steht im Code, was klickbar ist. Jev klassifiziert dann nur noch, welcher Schritt als Nächstes kommt. Jens' grundsätzlicher Punkt: Sprachmodelle sind keine Allzweckwaffe. Vieles löst man besser deterministisch im Code oder mit einem Klassifizierungsmodell.
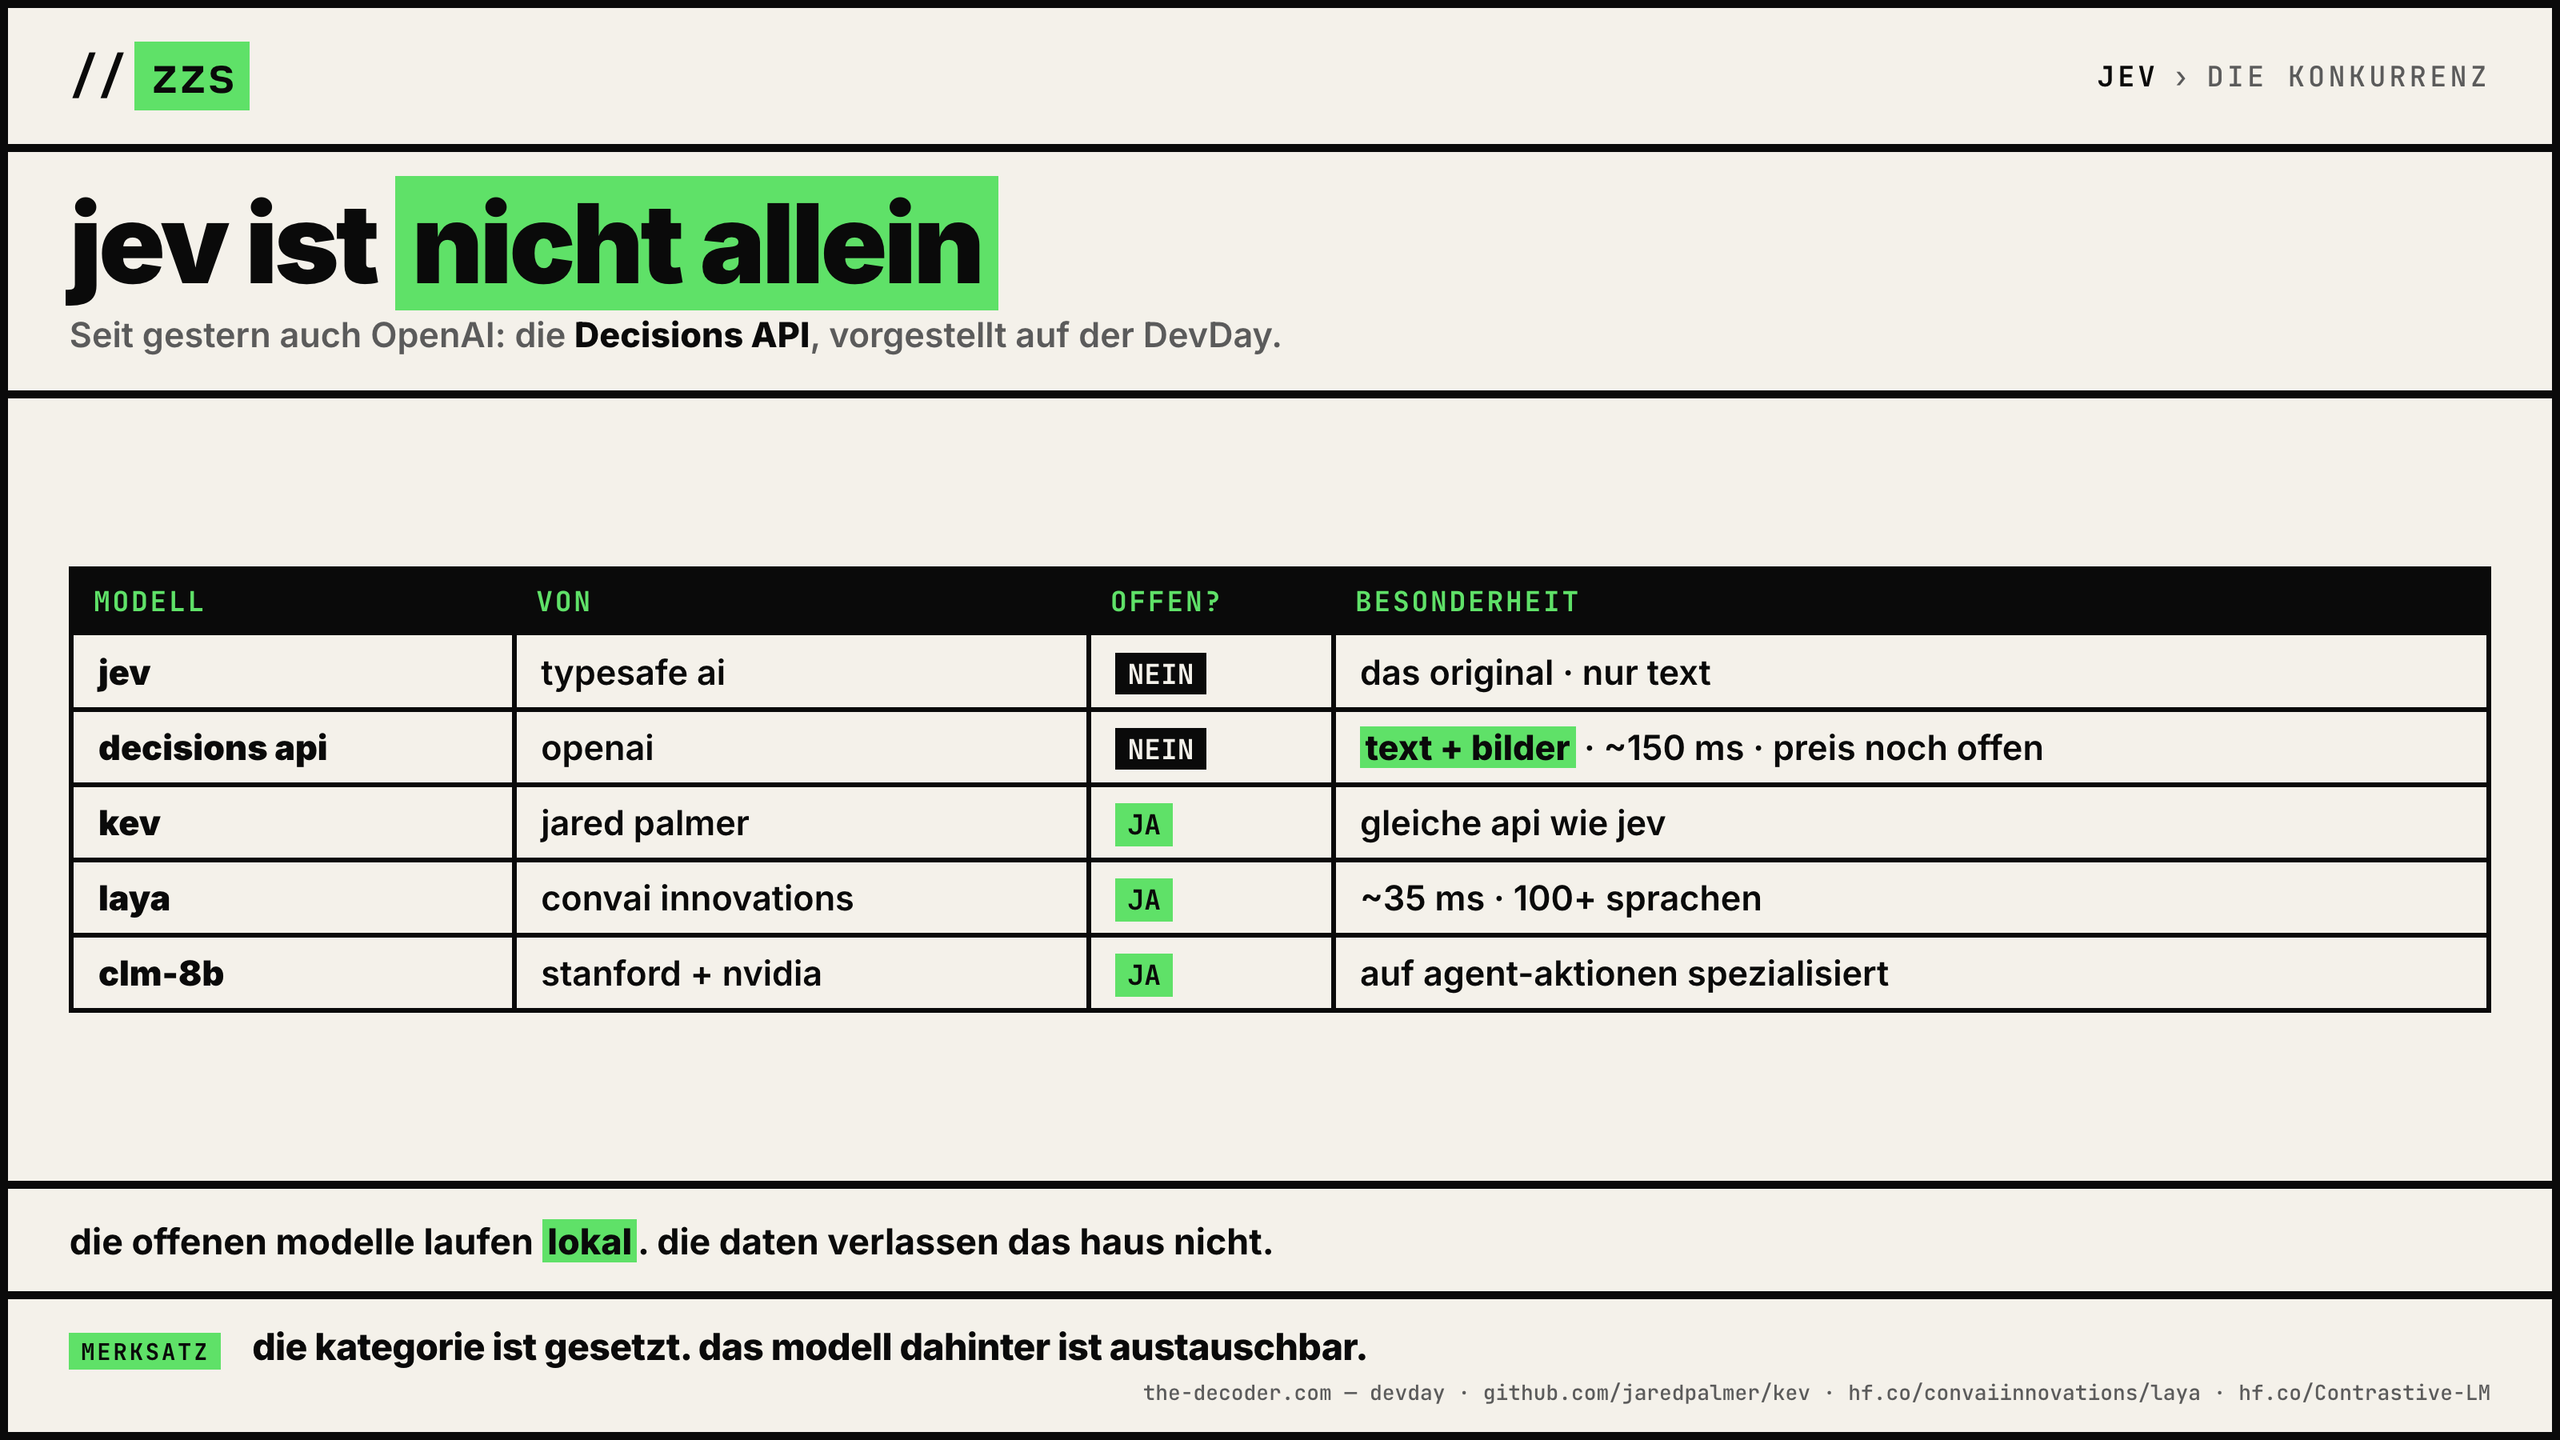
Jev ist auch nicht allein. Auf dem DevDay am Tag vor der Aufnahme hat OpenAI die Decisions API vorgestellt, die ähnliche Use Cases bedienen soll. Dazu kommen offene Modelle wie Kev und Laya. Laya steht auf Christophs Liste, vielleicht ist es ein Snack für die nächste Folge. Wofür sich Jev eignet, fasst Jens so zusammen: Jev übernimmt nur die unscharfen Entscheidungen, für die sich weder eine riesige Logik im Code noch ein Sprachmodell lohnt.
Dann Jens' eigenes Tool. Sein Buchhaltungs-Tool ist sevDesk, und Belege von Software-Anbietern hat er bisher aus dem Mailprogramm geladen, in sevDesk hochgeladen und dort Lieferant, Buchungskonto und Umsatzsteuer eingetragen. Lästig, und mit der Oberfläche war er nie zufrieden. Also hat er sich eine Personalized Software gebaut, komplett von Claude Opus 5.5 geschrieben, mit seinen Anweisungen und seinem Testing. Der Code läuft lokal, nur die Anfragen gehen an Jev. Die PDFs aus dem Postfach landen in einem lokalen Ordner. Im ersten Schritt entscheidet Jev, ob ein PDF überhaupt ein Beleg ist, im zweiten, wie es verbucht wird: Buchungskonto, Kategorie, Steuerregel. Ein guter Use Case, weil immer dieselben typisierten Antworten gebraucht werden, auf die man sich verlassen können muss, schnell und günstig.
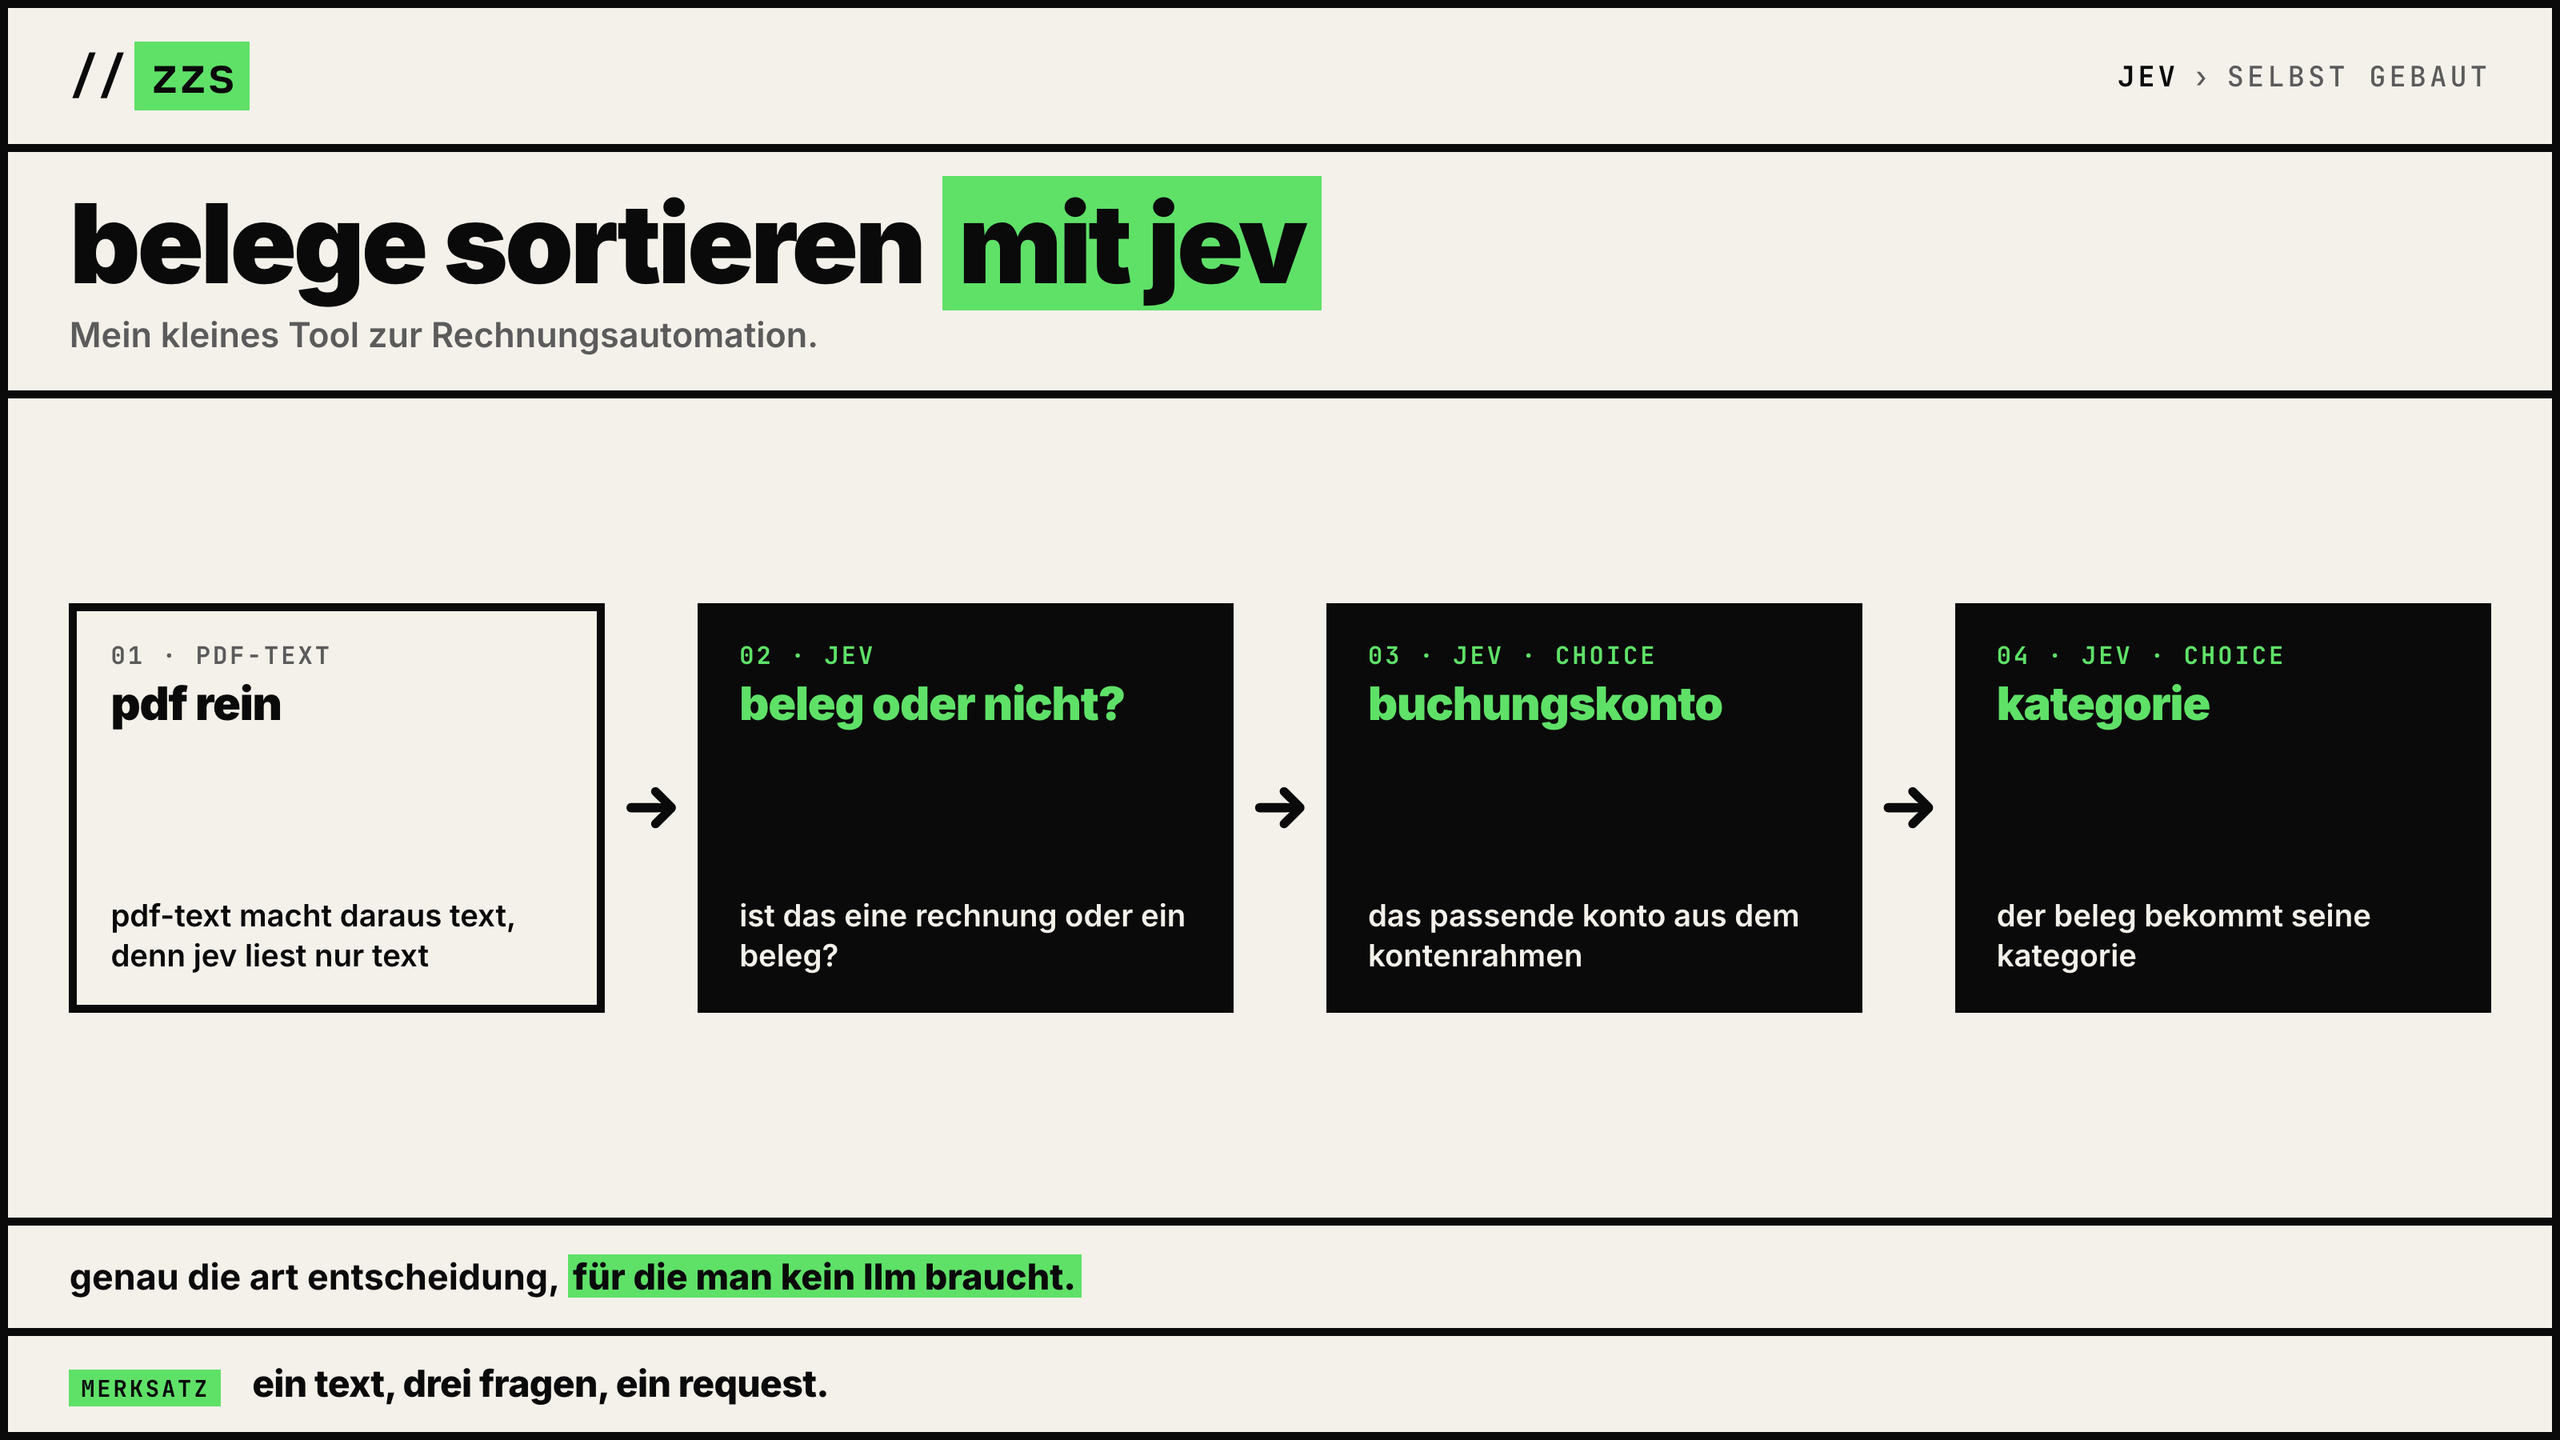
In der Demo, mit komplett fiktiven Daten, klassifiziert Jev 17 PDFs in etwa 400 Millisekunden. Eine AGB-Änderung ist kein Beleg, eine Gutschrift schon, eine Auftragsbestätigung wieder nicht. Für einen echten Beleg zeigt eine Debug-Ansicht, was an Jev geht: der State und die Fragen mit allen möglichen Buchungskategorien. Die Antwort kommt sofort, die Felder sind ausgefüllt, und gebucht wird direkt über die sevDesk-API. Was vorher im schlimmsten Fall fünf Minuten pro Beleg gedauert hat, dauert jetzt etwa zehn Sekunden.
Buchhaltung ist sensibel, deshalb Jens' Hinweis für alle, die so etwas nachbauen: Datenschutz und Sicherheit mitdenken. Bei ihm geht nur das an Jev, was wirklich gebraucht wird, persönliche Daten werden vorher entfernt. Für wiederkehrende Belege, etwa die monatliche Rechnung von Vercel, kann er Regeln anlegen: Einmal von Jev klassifiziert und bestätigt, im Zweifel mit dem Steuerberater abgestimmt, wird jeden Monat dieselbe Regel angewendet. Das macht den Prozess sicherer und effizienter.
Und die Kosten: 224 Aufrufe an Jev, rund 250.000 Input-Tokens, etwa 300 Millisekunden pro Aufruf, zusammen ein Cent. Mit Claude Haiku 4.5 oder Gemini 3.5 Flash Lite wäre es bis zu 27-mal teurer gewesen. Christoph, der für solche Aufgaben bisher Haiku genommen hat, ist ehrlich baff. Jens will den Preis nicht überbewerten, wer weiß, wie er sich entwickelt. Aber das Konzept, wofür das Modell gedacht ist, hält er für total sinnvoll.
Outro
Gut 50 Minuten, länger als geplant, aber es gab viel Inhalt. Beide finden das in Ordnung, weil man Themen überspringen kann. Und wer nur für die Snacks kommt, ist auch willkommen, oder liest später die Zusammenfassung auf der Website nach. Folgt uns auf YouTube, Spotify und überall, wo ihr uns hört, gebt einen Daumen hoch, wenn es die Plattform erlaubt, und schreibt uns in die Kommentare. Die nächste Folge kommt in zwei Wochen.